

共计 4934 个字符,预计需要花费 13 分钟才能阅读完成。
llama.cpp 是一个开源的本地大模型运行工具,仓库在 ggml-org/llama.cpp。它干的事情很简单:把网上下载的模型文件放在你自己的电脑上跑,没有显卡也能跑,聊天内容不出你的电脑。LM Studio 这类桌面软件,底层用的就是它。
11 月 13 日它发了 v1.0.0,这是项目 3 年半以来第一次挂上 1.0。X 上这两天中文、英文、日文、俄文的讨论都有,有一条中文帖说得挺准,大意是:这次没有新模型,也没提速,变的是规矩。
规矩是给开发者看的。我更想知道的是另一件事:一台没有显卡的普通电脑,装上它、下个小模型,到底能帮我干点什么。所以我在自己的 Linux 测试机上装了一遍,挑了三个 1–2B 左右的小模型,问了同样两道题。
🍎 本文的安装、下载、网页界面和接口调用都在 Linux 上实测;Windows、macOS 的安装命令取自官方文档,我没在这两个系统上跑过。
先说结论:问「洛杉矶和北京差几个小时」,三个模型全答错;把一句中文改成英文邮件,只有 1.7B 那个没丢信息。
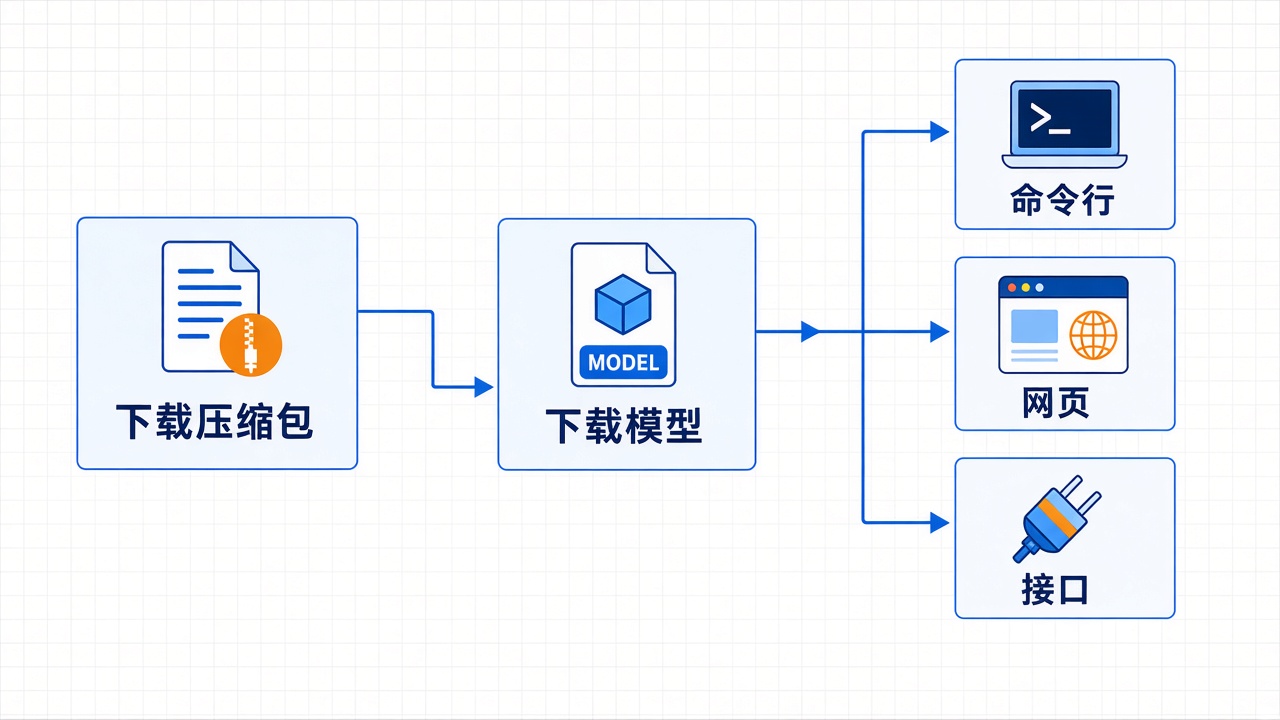
▲ 整个流程只有三步,后面按这个顺序讲
PART 1
1.0 里,普通用户用得上的几处
发布说明很长,大部分是写给开发者的,比如删掉了 35 个过时的函数、以后接口不兼容就升大版本号。跟普通用户有关的,我挑了三条,再加一条装之前该知道的:
- 网页界面重做了。 发布说明写的是聊天可以分组、输入框换成了能实时预览的 Markdown 编辑器,手机上也做了适配。
- 网页服务的安全补了几处。 发布说明列了 SSRF、CORS、DNS rebinding 这几类问题的修复。翻成大白话:别的网站想偷偷调用你电脑上的这个服务,现在更难了。
- 多了一个文字转语音的接口
/v1/audio/speech,跟 OpenAI 的写法一样。这次我没测语音。 - 装之前该知道的:用一个
llama命令就够了。 解压后有个叫llama的程序,llama cli是命令行聊天,llama serve开网页和接口,llama download下模型。llama-cli、llama-server这些单独的程序也在同一个文件夹里。
下载压缩包 → 下载模型 → 命令行 / 网页 / 接口
PART 2
装:一个压缩包,解压就能用
官方 README 首推的是一行安装脚本 curl -LsSf https://llama.app/install.sh | sh。我没用它,因为它会装到系统里。我想测完一删了事,就从发布页下了 Linux 的压缩包,放进一个单独的文件夹。
v1.0.0 的发布页没有直接放安装包,写的是「Nightly build: b12359」,点过去才是下载文件。Linux 普通电脑选 llama-b12359-bin-ubuntu-x64.tar.gz,23MB。我的测试机是 Debian 13,用 Ubuntu 这个包也能跑。
mkdir ~/llama-test && cd ~/llama-test
curl -LO https://github.com/ggml-org/llama.cpp/releases/download/b12359/llama-b12359-bin-ubuntu-x64.tar.gz
sha256sum llama-b12359-bin-ubuntu-x64.tar.gz
tar xzf llama-b12359-bin-ubuntu-x64.tar.gz
cd llama-b12359
./llama version
sha256sum 算出来是 0bc1f091e8916102b6d8f2cf944233a620e90a0f856c72d0ce41150c65c2e72e,跟 GitHub 上这个文件标的校验值一致。./llama version 应该输出:
version: 1.0.0-dev (build 12359, commit b1b770d90)
built with GNU 11.4.0 for Linux x86_64
版本号后面带着 -dev,别慌,发布页指向的就是这个构建。
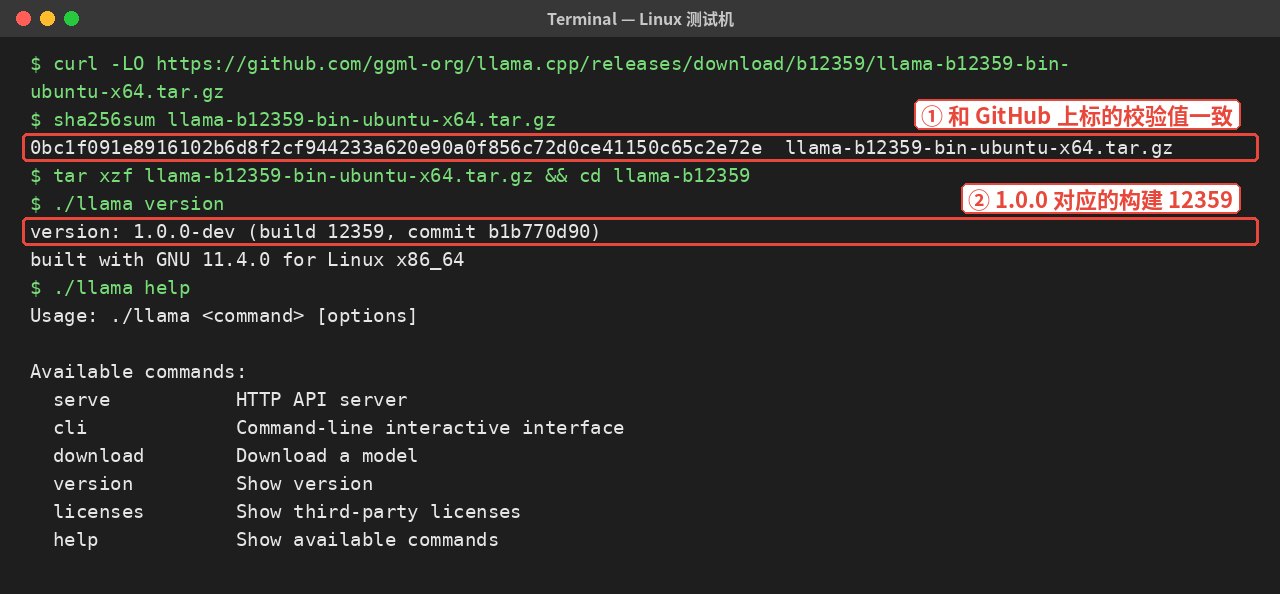
▲ 按我的测试机终端输出排版重绘,命令按正文写法整理,输出文字与原始日志一致
Windows 和 Mac,官方写的步骤是:
- Windows:
winget install llama.cpp - macOS:
brew install llama.cpp
装好后命令名一样,后面的步骤照着来。
PART 3
下模型,在命令行问一句
模型从 Hugging Face 下。-hf 后面写「作者/仓库:量化档位」,它自己找文件、自己下:
export LLAMA_CACHE=~/llama-test/models
./llama download -hf ggml-org/Qwen3-0.6B-GGUF:Q4_0
LLAMA_CACHE 是我加的,让模型下到测试文件夹里,删的时候好找。不设的话,模型会落到你用户目录下的 .cache 里。
这个 0.6B 模型 429MB,我这边下了 12 秒。下完问一句:
./llama cli -hf ggml-org/Qwen3-0.6B-GGUF:Q4_0 --offline -rea off -st -p "用三句话解释什么是时差,并给一个从洛杉矶打电话回北京的例子。"几个参数的意思:--offline 只用本地已经下好的模型,不联网;-rea off 关掉模型的「思考过程」,不然小模型会先絮叨一大段;-st 是问一轮就退出。不加 -st 就进入连续聊天,输 /exit 退出。
🍎 坑:量化档位不写会怎样?我试了 README 里的例子 ggml-org/Qwen3.5-0.8B-GGUF,没写档位,它给我下的是 Q8_0,834MB。帮助里说默认找 Q4_K_M,这个仓库没有 Q4_K_M,它就挑了别的。想省空间,就自己写上 :Q4_0。
PART 4
打开网页聊天
./llama serve -hf ggml-org/Qwen3-0.6B-GGUF:Q4_0 --offline不写端口的话,默认地址是 http://127.0.0.1:9931,我测试时加了 --port 8091。浏览器打开,就是一个很干净的聊天页,输入框右边会显示当前用的模型和大小。
这里有一行日志值得看一眼:
security: no API key is set and CORS allows all origins意思是现在谁都能调用它,没有密码。默认只听 127.0.0.1,也就是只有本机能连,自己用问题不大。如果你要让家里别的设备连进来(改 --host),先加个密码:
./llama serve -hf ggml-org/Qwen3-1.7B-GGUF:Q4_K_M --offline --api-key 你自己定的一串字加了密码后,网页第一次打开会是这样:
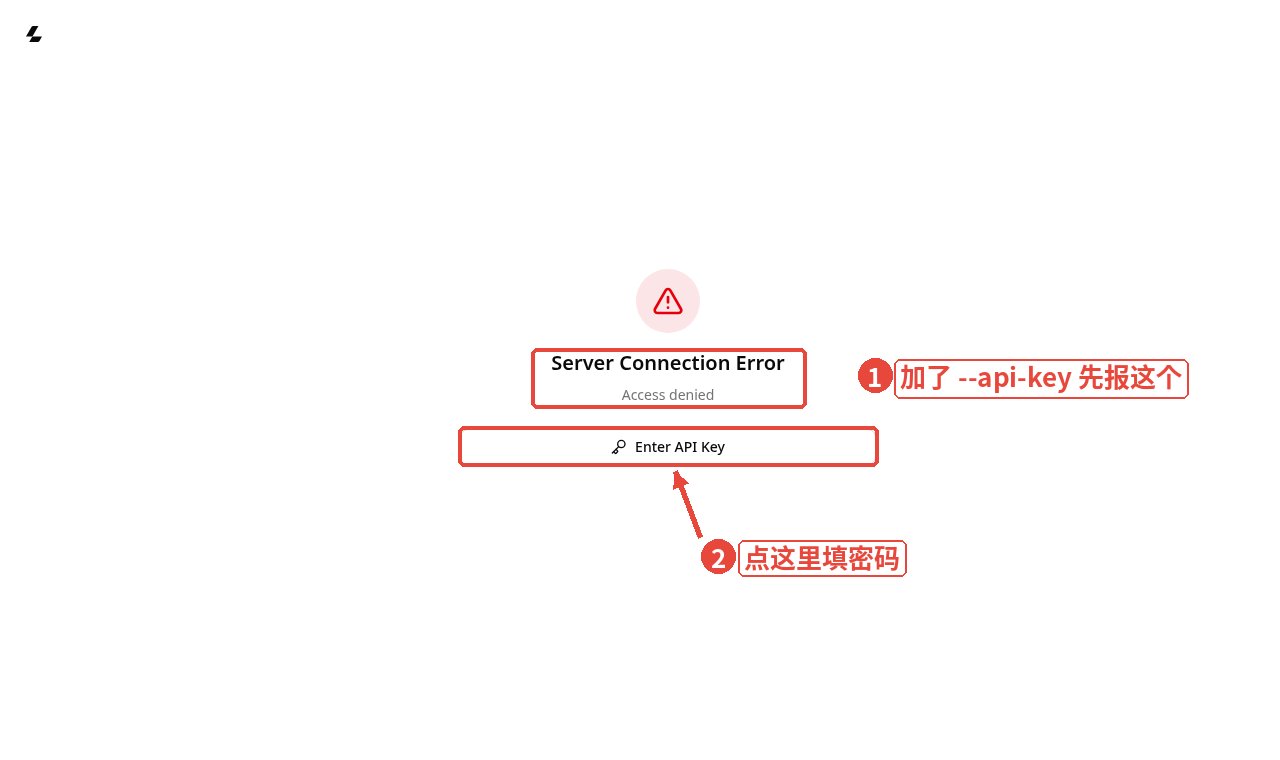
▲ 加了 –api-key 以后,网页先报 Access denied,这是正常的
点 Enter API Key,填进刚才那串字,点 Save & Retry,就能正常聊了。不带密码用 curl 调接口,会直接返回 401。
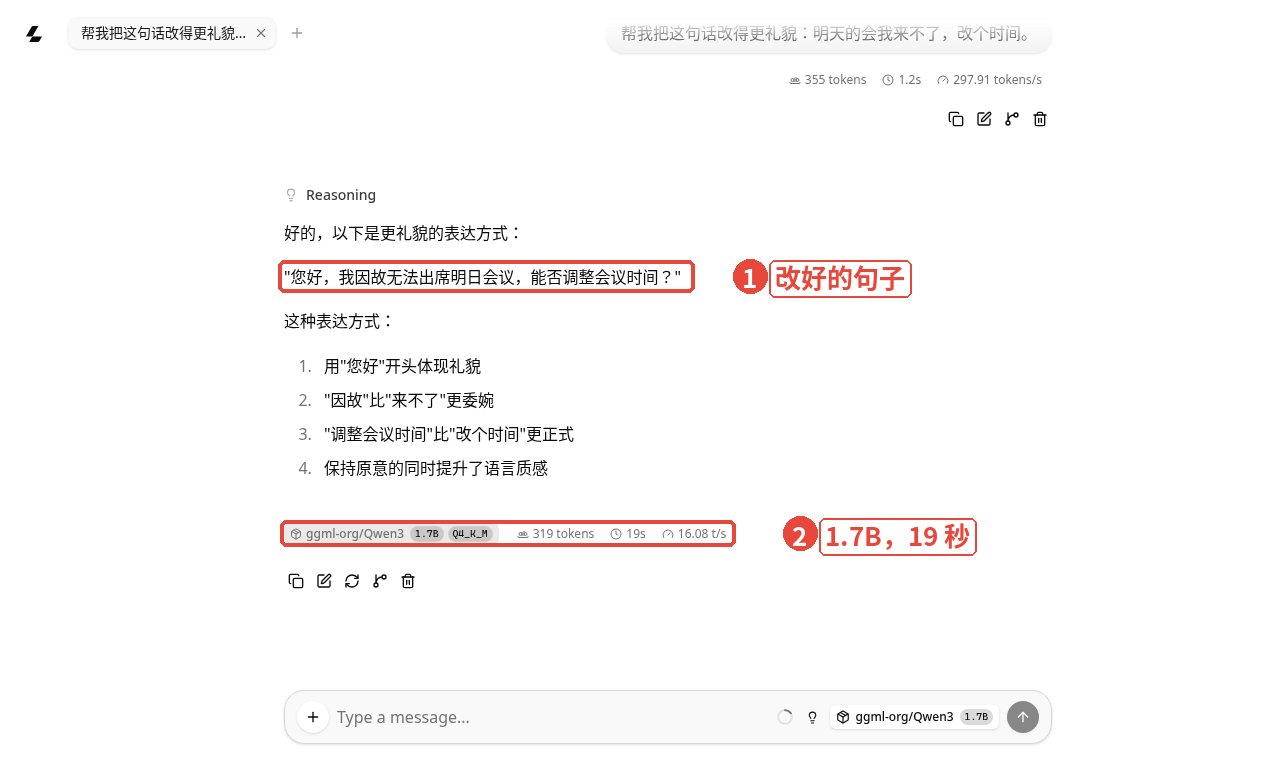
▲ 1.7B 改的这句能直接用。网页里默认带思考过程,这一条用了 19 秒
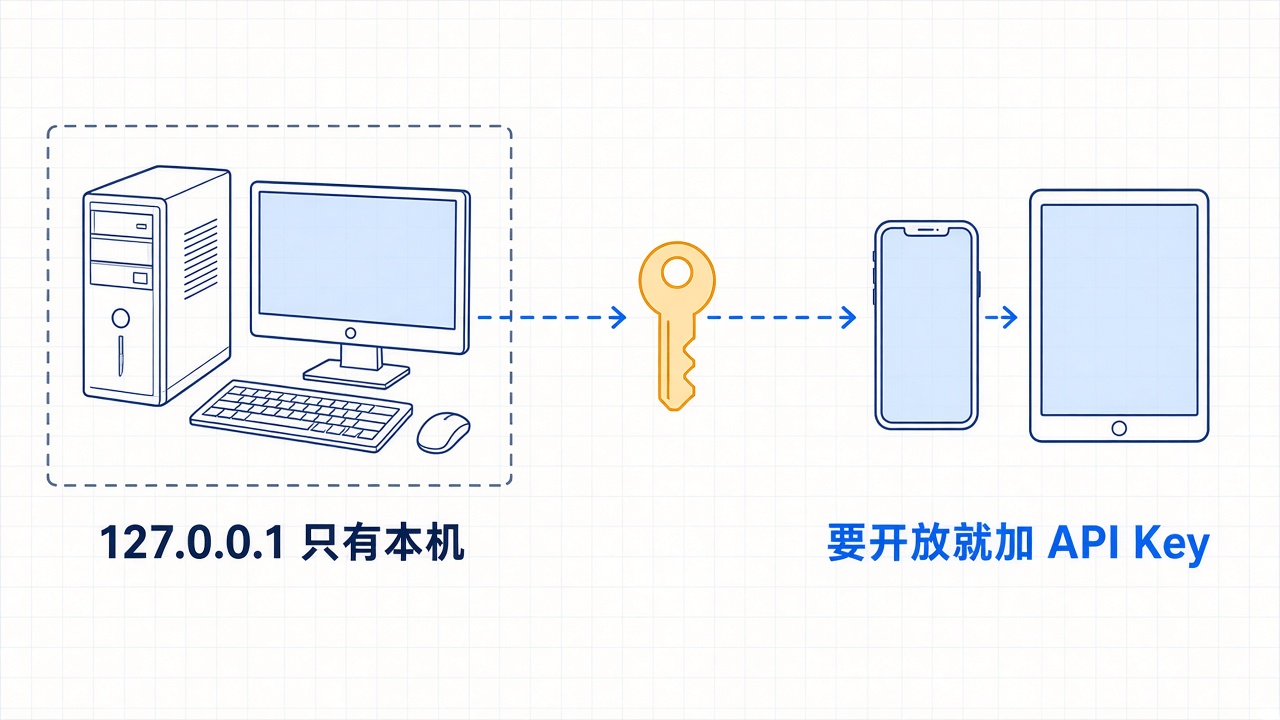
▲ 只在本机用不用改;要给别的设备用,先加密码
PART 5
三个小模型,同两道题
测试机配置:Intel Xeon 8 核,16GB 内存,没有显卡。三个模型都是 ggml-org 在 Hugging Face 上放的官方转换版:
- Qwen3-0.6B,Q4_0,429MB
- Qwen3.5-0.8B,Q8_0,834MB(README 里的例子,没写档位下到的就是它)
- Qwen3-1.7B,Q4_K_M,1.28GB
速度用自带的 llama bench 跑了 3 轮,题目是两道:一道问事实,一道翻译。
| 模型 | 体积 | 生成速度 | 时差题 | 翻译题 |
|---|---|---|---|---|
| Qwen3-0.6B Q4_0 | 429MB | 约 242 个/秒 | 错 | 丢了周二 |
| Qwen3.5-0.8B Q8_0 | 834MB | 约 58 个/秒 | 错 | 丢了周二十点 |
| Qwen3-1.7B Q4_K_M | 1.28GB | 约 22 个/秒 | 错 | 对 |
生成速度的单位是 token(模型处理文字的最小单位,一个汉字大约一到两个)。三轮之间波动不小,1.7B 是 22.1±9.2,看个数量级就行。
时差题:三个都错
题目是「用三句话解释什么是时差,并给一个从洛杉矶打电话回北京的例子」。正确答案:今天 11 月 16 日,洛杉矶已经结束夏令时,是 UTC-8,北京是 UTC+8,北京比洛杉矶快 16 个小时;夏令时期间是 15 个小时。
三个模型的原话:
- 0.6B:「从洛杉矶到纽约的时间差大约是10小时」「在洛杉矶打电话回北京时,时间差大约是14小时」,两个数都错。
- 0.8B:它写对了「洛杉矶(太平洋时区 UTC-8)」「北京(东八区 UTC+8)」,下一句却说时间「会落后一小时」。
- 1.7B:「北京的时间比洛杉矶晚8小时」,方向和数字都不对。
这么小的模型,查时间、汇率、日期这类事实就别用了,三个都答得很笃定,三个都错。
翻译题:1.7B 没丢信息
原句:「您好,我下周二上午十点到不了,能改到周四下午两点吗?给您添麻烦了。」要求译成礼貌、简短的英文邮件正文。
- 0.6B:「I’ll be back at 2 p.m. on Thursday afternoon.」周二来不了这层意思没了,读起来像「我周四两点回来」。
- 0.8B:「could you please adjust my arrival until Thursday afternoon at 2:00 PM instead?」周二十点也没了。
- 1.7B:「I apologize for being unable to attend at 10:00 AM next Tuesday. Could you kindly reschedule my appointment to 2:00 PM on Thursday?」时间、道歉、请求都在,还自己加了个邮件标题。
网页里那道改礼貌的题也一样。0.6B 把「明天的会」改成了「明天的聚会」:
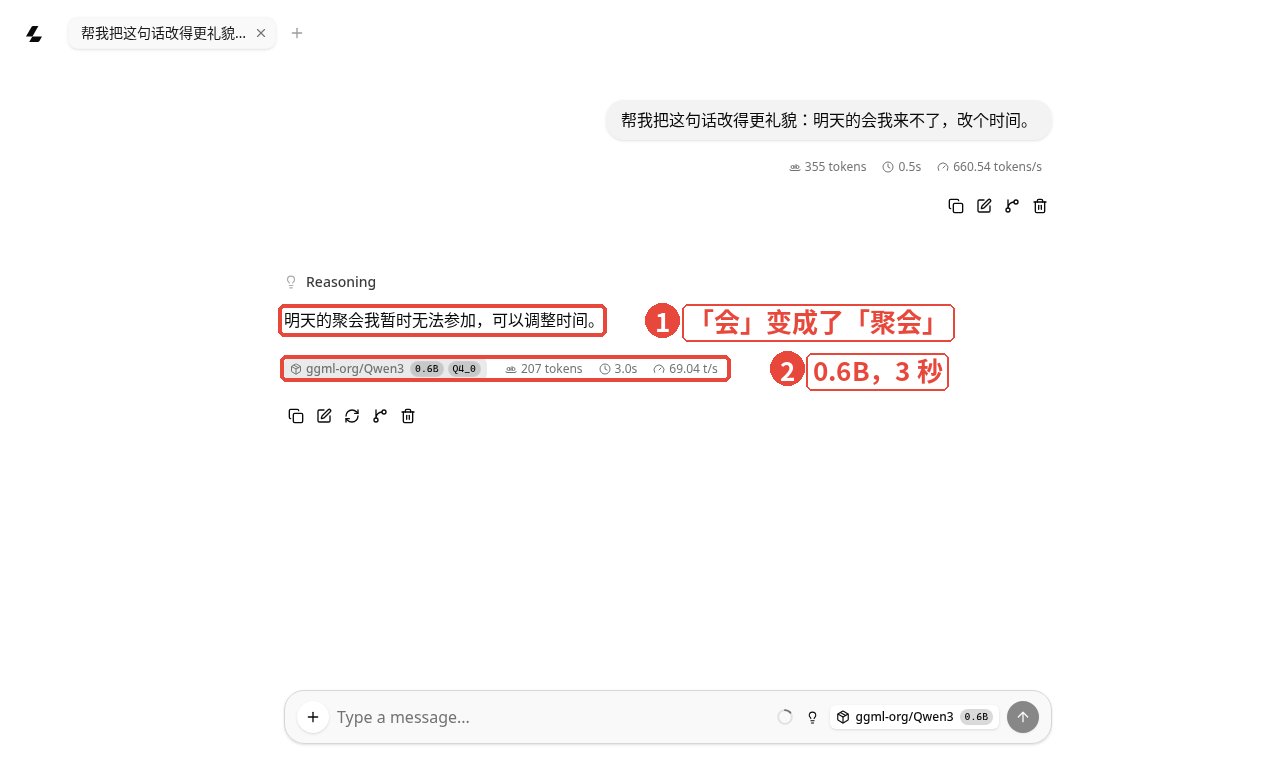
▲ 0.6B 很快,3 秒出结果,可「会」变成了「聚会」
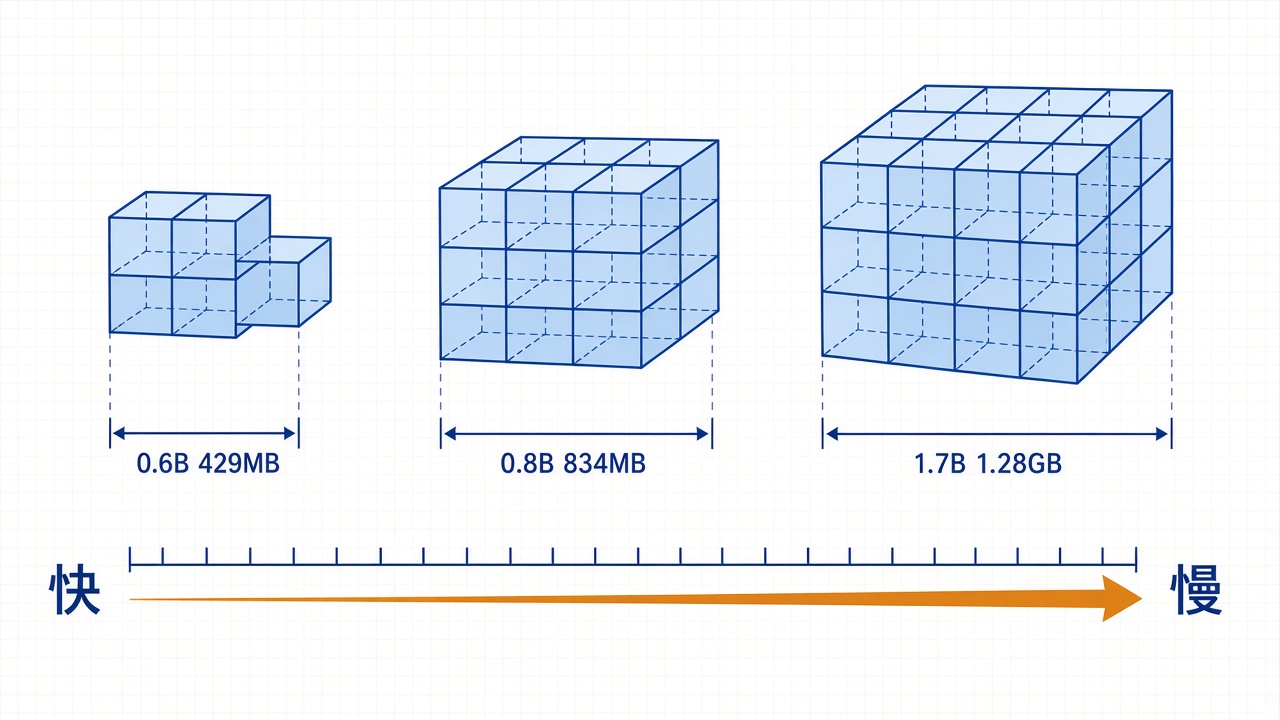
▲ 模型越小越快,这次最快的 0.6B 错得也最多
我的看法:只想有个离线的翻译、改写小帮手,下 1.7B 这档,1.28GB。网页里带着思考过程,一句话要十几二十秒;走接口关掉思考,两三秒就回来了。0.6B 适合拿来确认「装好了、能跑」,别指望它干活。
PART 6
当成翻译接口,让别的工具来调
llama serve 开着的时候,同一个地址还有一个跟 OpenAI 写法一样的接口。很多支持「自定义 OpenAI 地址」的软件,地址填 http://127.0.0.1:你的端口/v1 就能接上。
我用 curl 直接调了一次,把请求写进 req.json:
{"model":"ggml-org/Qwen3-1.7B-GGUF:Q4_K_M",
 "messages":[
  {"role":"system","content":"把用户的中文翻译成礼貌、简短的英文邮件正文,只输出译文。"},
  {"role":"user","content":"您好,我下周二上午十点到不了,能改到周四下午两点吗?给您添麻烦了。"}],
 "max_tokens":200,
 "chat_template_kwargs":{"enable_thinking":false}}
curl -s http://127.0.0.1:8091/v1/chat/completions \
-H 'Authorization: Bearer 你自己定的一串字' \
-H 'Content-Type: application/json' -d @req.jsonenable_thinking 设成 false,是让 Qwen3 不输出思考过程,直接给答案。我调了两次,分别用了 2.9 秒和 1.7 秒。两次措辞不太一样,周二十点、周四两点都在。
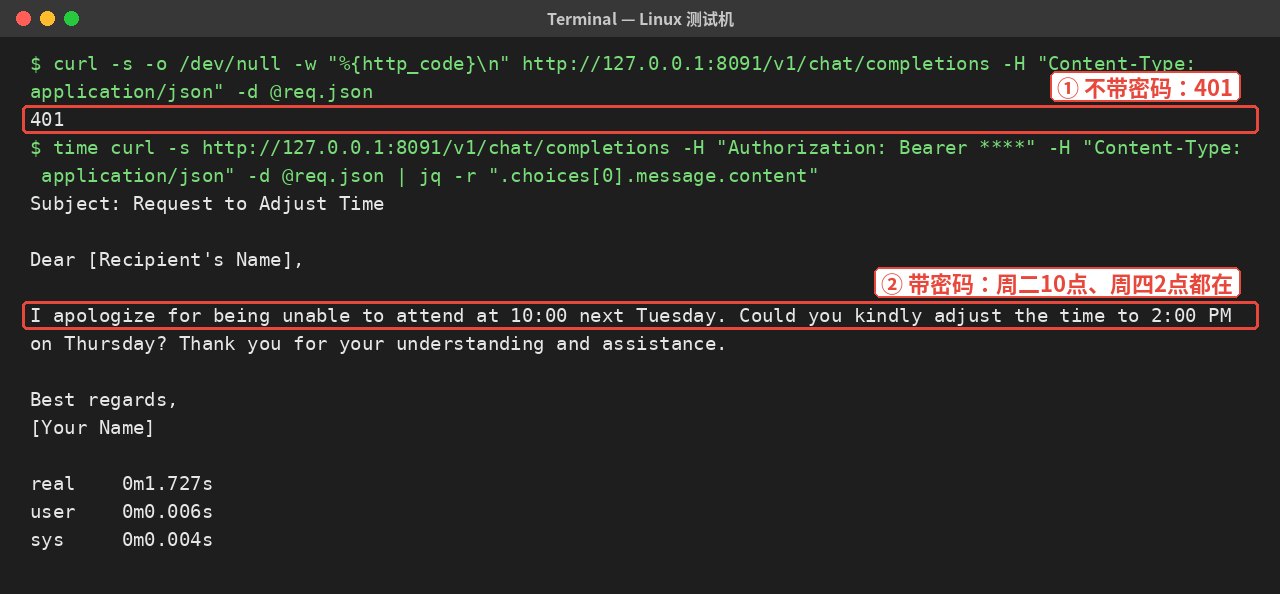
▲ 按我的测试机终端输出排版重绘,密码已打码,译文与接口原始返回一致
用完怎么删干净
按上面的方法装,所有东西都在 ~/llama-test 一个文件夹里。不想要了,先在终端按 Ctrl+C 停掉 llama serve,再删掉这个文件夹。我这次三个模型加程序,一共占了 2.5GB 左右。
如果没设 LLAMA_CACHE,模型在用户目录的 .cache 里,记得一起删。
· · ·
🍎 相关阅读:想看小模型接进别的工具的效果,可以看 DeepTutor 1.7 接本地小模型实测;想在电脑上做一个能定时干活的 AI 助手,可以看 Open Duet 安装和使用教程。






