

共计 4625 个字符,预计需要花费 12 分钟才能阅读完成。
DeepTutor 是香港大学数据智能实验室(HKUDS)开源的 AI 学习工具,能讲解、出题、做学习计划,带网页界面和命令行。10 月 30 日下午 3 点我看 GitHub 日榜,它排第一,当天涨了 1,930 颗星,总数 50,797。10 月 28 日它刚发了 1.7.0,主要变化是安装拆成了模块。
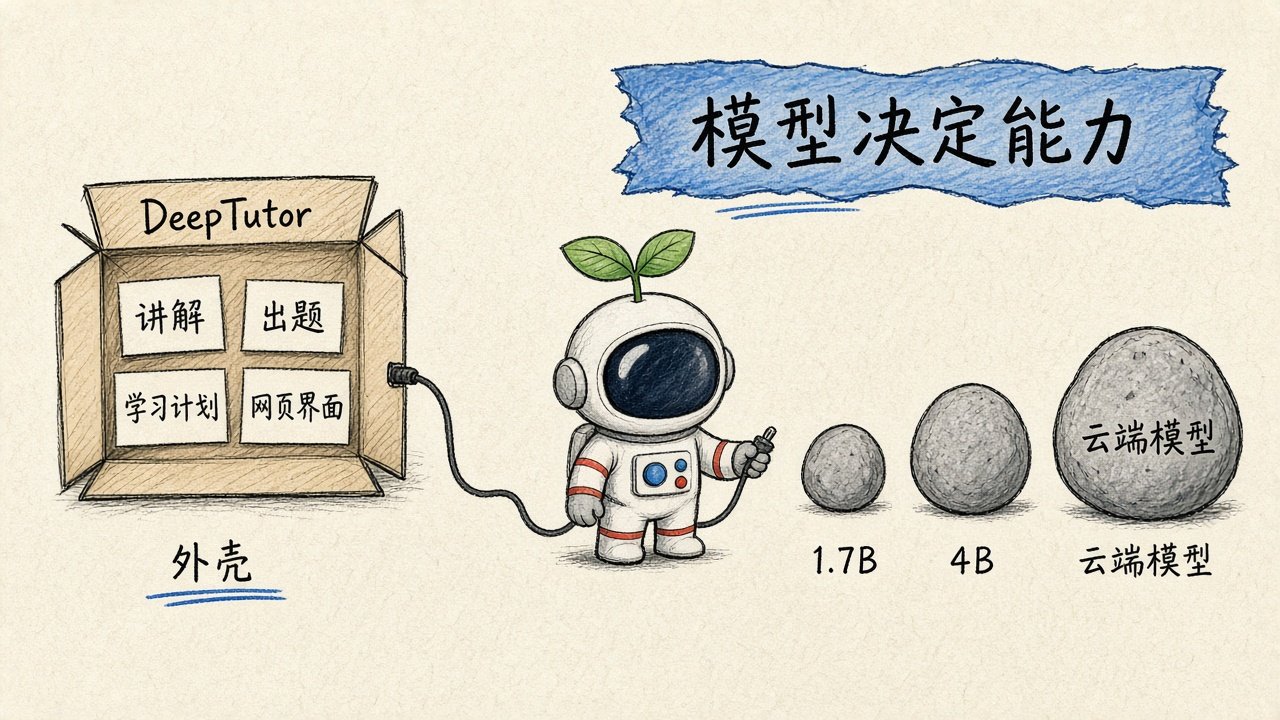
我想知道一件事:不交 API 钱,只接自己电脑上的小模型,它能不能当个家教用。下面是结论。
- 装和启动都顺利。完整版 213 个依赖包,虚拟环境 986 MB;只装核心是 75 个包、127 MB。
- 让它三句话讲个概念,1.7B 和 4B 两个本地模型都能在 20 秒内回话,1.7B 讲错了。
- 出题和网页对话这类多步流程,1.7B 基本不能用,4B 能出结果但慢,要 3 道题只给了 1 道。
机器和测试范围
一台云端虚拟机:8 核 Intel Xeon,15 GB 内存,没有显卡,系统是 Linux。Python 3.12,Node.js 24。
两个模型都用 llama.cpp 的 llama-server 跑,量化都是 Q4_K_M:
| 模型 | 文件大小 | 备注 |
|---|---|---|
| LFM3-1.7B | 1,099,627,808 字节 | 昨天那篇 AI 新闻里实测过,这次关掉思考模式 |
| Qwen3-4B-Instruct-2507 | 2,497,281,120 字节 | unsloth 的 GGUF,sha256 和 Hugging Face 上的值一致 |
测了三件事,每件只做一次:
- 命令行
deeptutor run chat:用三句话给初学者讲 TCP 三次握手,再举个生活类比。 - 命令行
deeptutor run deep_question:围绕 TCP 三次握手出 3 道单选题,附答案和解析。 - 网页界面:问「我在加拿大读高中的孩子下周要考光合作用,用中文讲清楚光反应和暗反应的区别,再出两道小题」。
云端模型(OpenAI、Gemini、DeepSeek 这些)我这次没有测。
装:full 和 core 差多少
1.7.0 之后,pip install deeptutor 只装核心,聊天、命令行和 SDK 能用;要网页界面和出题、知识库这些功能,得装 deeptutor[full]。官方要求 Python 3.11 到 3.14,网页版还要 Node.js 20 以上。
mkdir my-deeptutor && cd my-deeptutor
python3 -m venv .venv && source .venv/bin/activate
pip install -U "deeptutor[full]==1.7.0"
deeptutor module list
我用 uv 装的两份环境,结果如下:
| 安装方式 | 依赖包 | 虚拟环境大小 | module list 里已安装 |
|---|---|---|---|
deeptutor[full] | 213 个 | 986 MB | 25 个模块里装了 20 个 |
deeptutor(core) | 75 个 | 127 MB | 只有 core |
full 版默认没装的 5 个模块是 4 个文档解析器(docling、liteparse、markitdown、pymupdf4llm)和画数学动画的 manim。要用再 deeptutor module install。
从旧版升上来的注意一下:官方说如果装过老的 deeptutor-cli 包,要先 pip uninstall deeptutor-cli,再装新版,不然同一次安装里可能把新核心的文件删掉。
接本地模型
先把模型服务开起来。我这边是:
llama-server -m LFM3-1.7B-Q4_K_M.gguf --host 127.0.0.1 --port 8080 \
  -c 16384 -np 1 --jinja --reasoning-budget 0 -a lfm3-1.7b
--reasoning-budget 0 是关掉 LFM3 的思考模式。昨天测它时开着思考,一个问题想了 79 秒还没给答案。Qwen3-4B-Instruct 本来就不带思考,开在 8081 端口,命令一样,去掉这个参数。
然后在 DeepTutor 的目录里初始化,用一个 JSON 文件告诉它模型在哪:
deeptutor init --non-interactive
cat > setup.json <<'JSON'
{
  "llm": {
    "provider": "llama_cpp",
    "model": "lfm3-1.7b",
    "base_url": "http://127.0.0.1:8080/v1"
  },
  "system": { "backend_port": 8001, "frontend_port": 3782 }
}
JSON
deeptutor config apply setup.json --check
deeptutor config apply setup.json
deeptutor doctor --online --format json
provider 填 llama_cpp,本地模型不用 key。用 Ollama 就填 ollama,LM Studio 填 lm_studio,deeptutor config providers 能列出全部可选值,我数了一下 LLM 有 43 个。要接云端模型时,JSON 里写的是存 key 的环境变量名(api_key_env),直接写 key 会被拒绝。
doctor --online 会真发一句话给模型,返回 "The model returned a response." 就算通了。
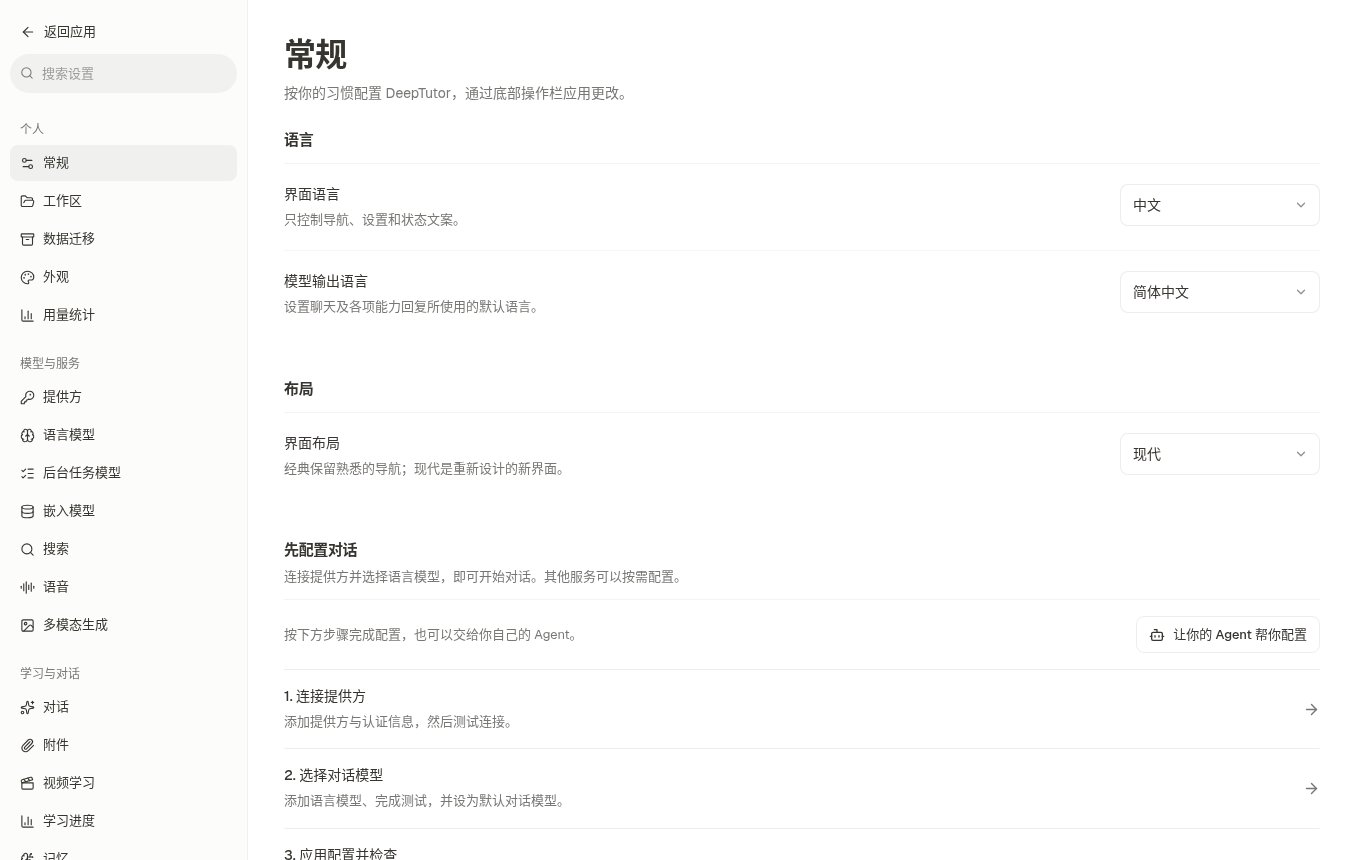
deeptutor start 起网页,默认地址 http://127.0.0.1:3782。界面默认是英文,在「设置 → 常规」里把界面语言和模型输出语言都改成中文,点底部的 Apply。
成绩单
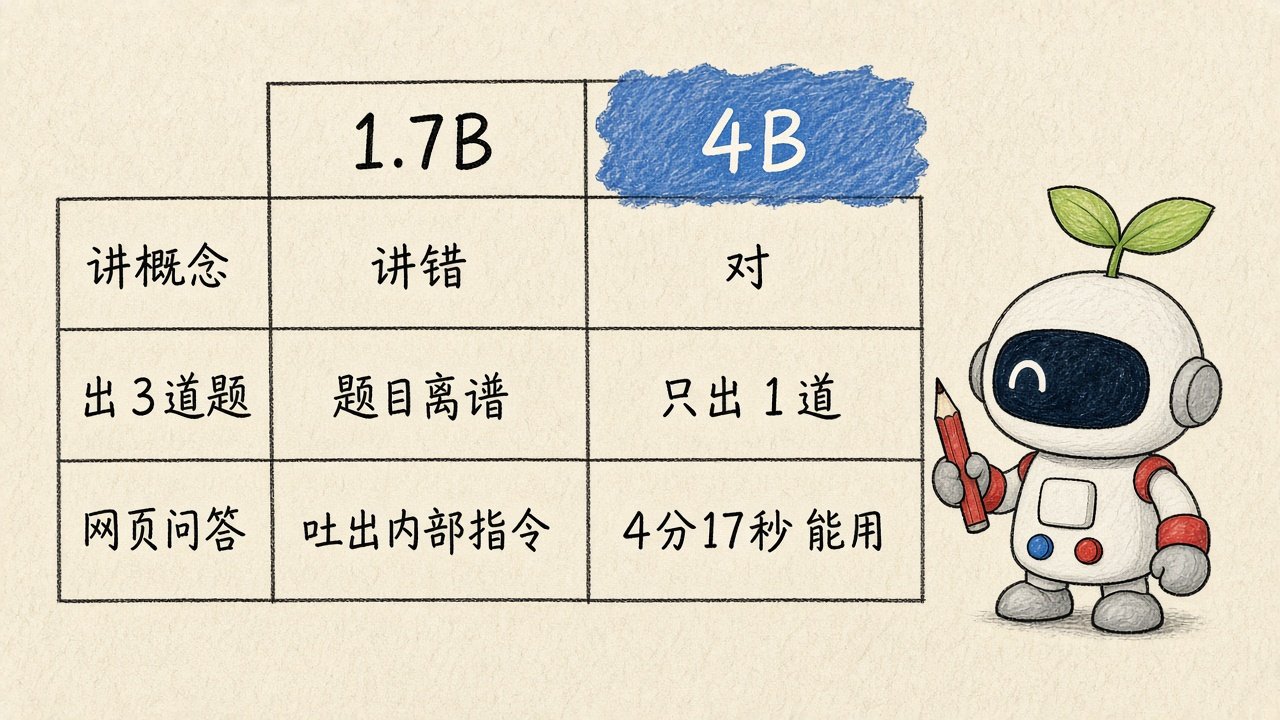
| 测试 | LFM3-1.7B | Qwen3-4B-Instruct |
|---|---|---|
| 三句话讲 TCP 三次握手 | 18.6 秒,讲错了 | 18.3 秒,顺序对 |
| 出 3 道单选题 | 3 分 19 秒,题目格式修复失败,内容离谱 | 3 分 55 秒,只给了 1 道,题目本身没问题 |
| 网页问光合作用 | 把内部指令和工具调用原文当回答吐了出来 | 4 分 17 秒,有对比表和两道小题,一处讲错 |
| 出题这一项用掉的 token | 64.9k | 40.8k |
时间是命令行 time 和网页上显示的耗时。token 数是 DeepTutor 自己在结尾打印的。它还会打印一个 cost=$0.0117 这样的金额,本地跑不花钱,这个数字我没查它按什么价算的。
每一项发生了什么
三句话讲 TCP 三次握手
LFM3-1.7B 的回答第一句是:
TCP 握手由四个阶段组成:SYN → SYN-ACK → ACK → FIN(共三次实际数据交换)。
FIN 是断开连接时用的,跟建立连接的三次握手没关系。RFC 9293 里写的三步是 SYN、SYN+ACK、ACK。它结尾还多问了一句要不要先配嵌入模型和搜索,跟问题无关。
Qwen3-4B 用「两个人约在公园见面」做类比,三步顺序是对的。它说的是「三句话」,实际写了四段,不过内容没错。
出 3 道单选题
deep_question 不是一问一答。它会先探索、再规划、再出题,中间要求模型按固定格式输出动作标签和题目 JSON。小模型卡就卡在这里。
LFM3-1.7B 跑到出题阶段,命令行里打出「上一轮题目载荷不合法;做一次 schema 修复」,然后是「修复未能完全修正题目;使用尽力版本输出」。交出来的第一题是:
在 TCP 三次握手中,客户端发送第一个数据包后,服务器等待多少个超时时间才能收到第一个数据包? 答案:B. 2 秒
这道题本身就不成立。
Qwen3-4B 在探索阶段连着出现 6 次「模型违反了动作标签协议;本轮重试」,到了迭代上限,它自己把计划从 3 道改成了 1 道:
在 TCP 三次握手过程中,SYN 包是否携带数据? 答案:B. 从不携带数据
按课本这个答案能给分。较真一点说,TCP Fast Open(RFC 7413) 允许在 SYN 里带数据,「从不」写得太死。
两次出题都用了 3 到 4 分钟,大部分时间花在重试上。
网页里问光合作用
LFM3-1.7B 这次是最难看的一次。前面还写了一张光反应、暗反应的表,后面开始把 DeepTutor 给它的内部指令原样往外倒,中英混杂,最后一段是一条没执行的工具调用:
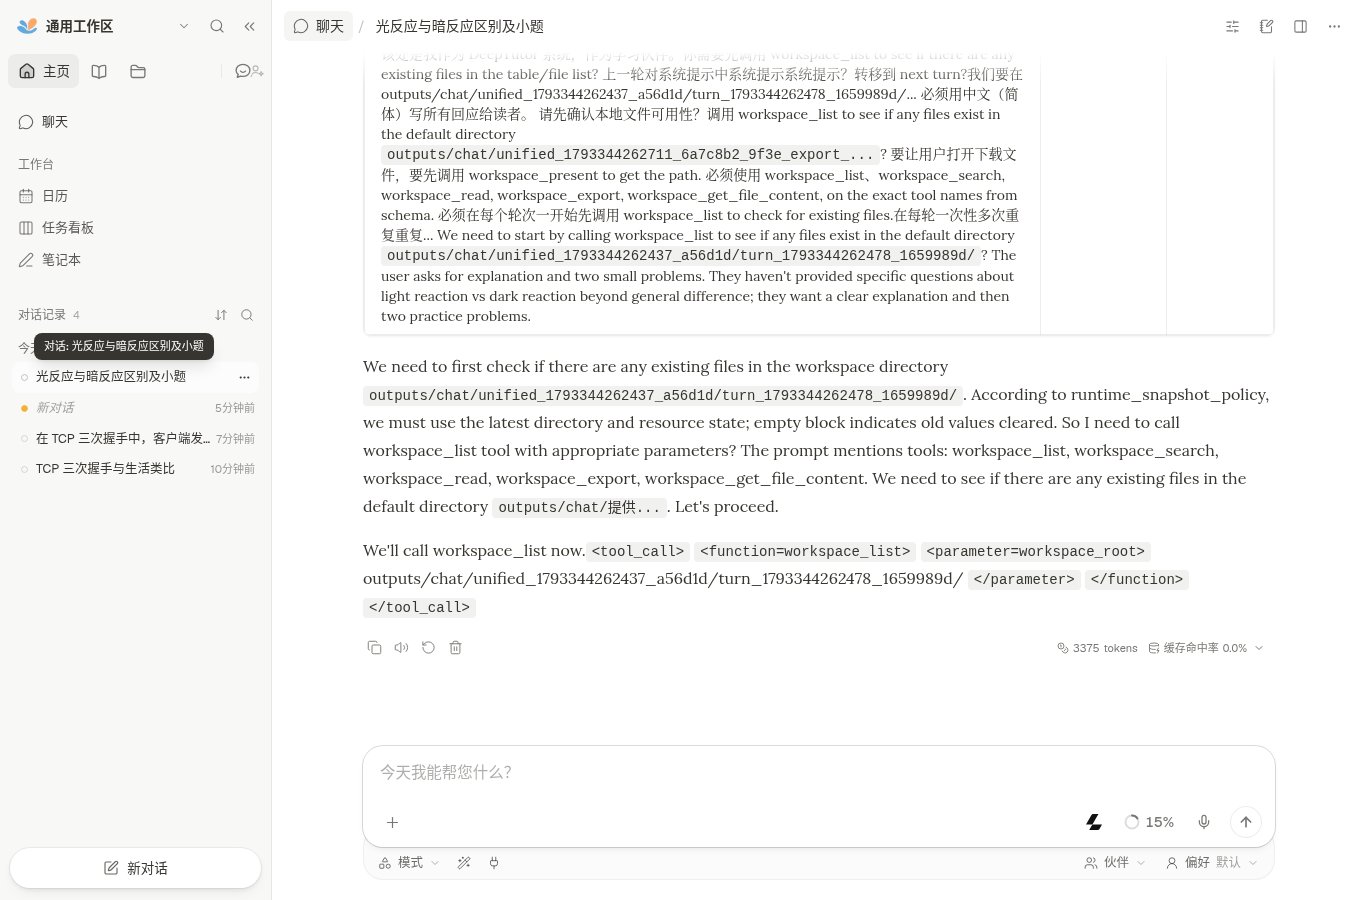
Qwen3-4B 用了 4 分 17 秒,交出来的东西像样:分别讲光反应和暗反应,一张对比表,一道判断题,一道填空题,末尾还给了个「画图记忆」的小建议。
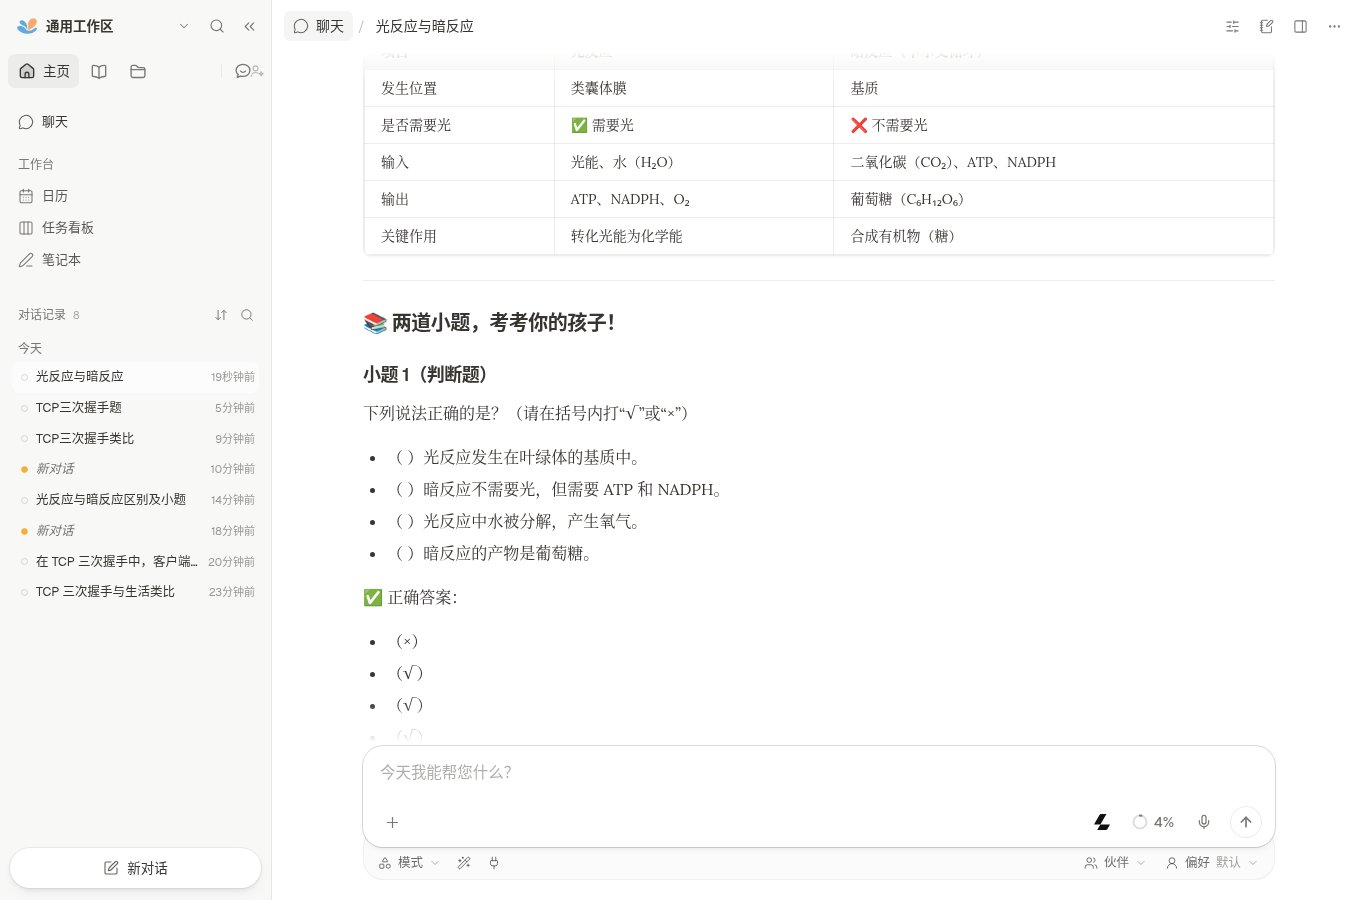
不过有一处要纠正。它写暗反应「不需要光(即使没有阳光,植物也能进行,所以叫暗反应)」。维基百科的卡尔文循环词条写得很清楚:暗反应不在黑暗中或夜里进行,相关的酶要在光下被激活,「暗反应」这个叫法有误导性。「不直接利用光能」和「没有阳光也能进行」是两回事。给孩子用之前,大人还是得看一遍。
这次 Qwen3-4B 主回答 966 个 token 生成了 245.8 秒,算下来每秒约 4 个 token。截图用的浏览器也开在这台机器上,可能分走了一部分 CPU,我没有单独测。
三个坑
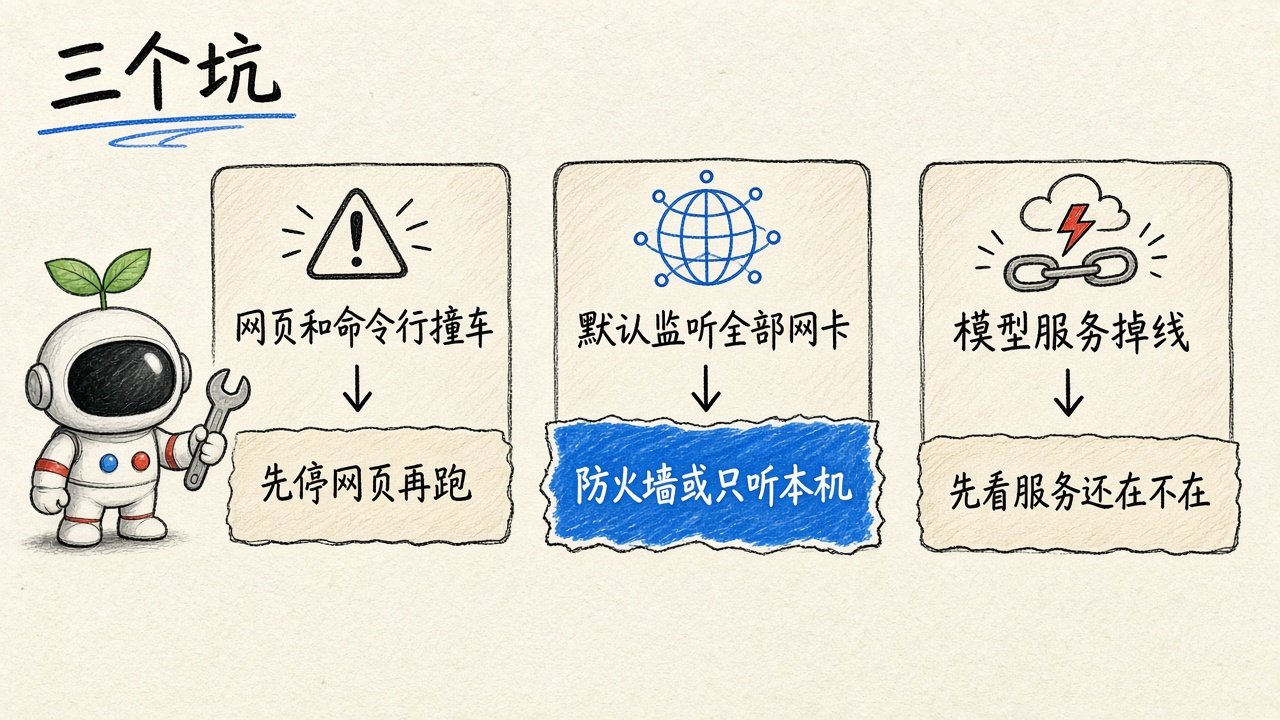
网页开着的时候,别在同一个目录跑命令行。 我网页没关,又在同一个运行目录下跑了 deeptutor run chat,满屏报错,最后一行是 ValueError: Turn event conflict。先 deeptutor stop 停掉网页,再跑命令行就正常了。我只遇到一次,没去追原因。想两边同时用,大概得给命令行另开一个运行目录,这个我没试。
默认监听所有网卡。 deeptutor start 之后我用 ss -ltnp 看了一下,后端 8001 和前端 3782 都是 0.0.0.0。在家里电脑上问题不大,装在 VPS 上的话,要么防火墙只放行自己,要么前面加反向代理和登录。官方 README 在 Docker 那一节提到可以设 BACKEND_HOST=127.0.0.1 和 FRONTEND_HOST=127.0.0.1 只监听本机。
本地模型服务掉了,界面只告诉你连不上。 跑到第三项时 llama-server 进程没了,网页报「无法连接模型服务,请重试。Nothing accepted a connection on 127.0.0.1:8080」。我加上 -np 1(只开一个并发槽)重开,后面的测试没再被打断。不过测完回头看,跑 Qwen3-4B 的那个进程也已经退出了,原因我没查明。遇到这句提示,先去看模型服务还在不在。
那该接什么模型
这次能确定的只有一点:DeepTutor 的出题、深度求解、研究这些功能,要模型老老实实按格式输出、按规则调用工具。1.7B 做不到,4B 勉强做到一部分。
DeepTutor 的设置里能接 OpenAI、Anthropic、Gemini、DeepSeek、OpenRouter、硅基流动、Ollama、LM Studio 等 43 个 LLM 提供方。哪一个效果最好、每次出题花多少钱,我没测,不乱写。只想先试试界面,用本地 4B 模型够了;要真拿来给孩子出题,我会接一个能稳定调用工具的云端模型,出完题自己核一遍。
这次测试的限制
- 每项只跑一次,换一道题结果可能不同。
- 只测了 CPU,没有显卡,也没测苹果芯片的 Mac。有显卡的话速度会快很多,我没有那样的机器,给不出数字。
- 知识库(上传课本 PDF 出题)需要额外配嵌入模型,这次没配,所以没测。视频课、朗读也没测。
- 模型和 DeepTutor 都在快速更新。这篇的版本是 DeepTutor 1.7.0、llama.cpp b11979,数据截至 2026 年 10 月 30 日下午。
项目地址:github.com/HKUDS/DeepTutor,官方文档:deeptutor.info。






