

共计 6261 个字符,预计需要花费 16 分钟才能阅读完成。
给编程助手装一个技能,通常是把一份带 SKILL.md 的目录放进项目,或者按文档执行安装命令。装完之后会不会被某个助手完整读到,说明书写得清不清楚,往往要等到真正提问时才暴露。
NVIDIA 开源的 SkillEvaluator 把其中两道检查做成了命令。quality-check 给技能的说明和结构打百分制;harness-check 按它内置的助手配置,判断这项技能是能加载、会降级,还是会被丢掉。这两道检查都不需要模型钥匙,也不需要 GPU 或 Docker。2026 年 11 月 18 日 8 点 10 分(北京时间),项目发布了 v1.0.1,并把加载检查写进了正式说明。
同一天下午,我在 Linux 测试机上安装了 PyPI 上的 1.0.1,对两份技能目录各跑了一遍。一份是仓库自带的官方示例 text-analyzer;另一份是公开项目 last30days-skill 的技能目录,我把它复制出来当真实样本。质量检查的默认及格线是 70 分。官方示例得了 88.8 分,等级 B,六个助手都显示为加载;last30days 得了 78.5 分,等级 C,仍然算通过,但六个助手里 OpenClaw 被标成降级。
🍎 实测环境:Linux,Python 3.13.5,uv 0.13.8。用虚拟环境执行 uv pip install skillevaluator==1.0.1,命令行回报 skillevaluator, version 1.0.1。官方示例来自仓库标签 v1.0.1(提交 914c15cb)。第二份样本来自 mvanhorn/last30days-skill v4.3.2,许可证 MIT。Windows 和 macOS 我没有跑过。更深层的 validate、相似度检查和现场评测需要钥匙或 Docker,这次没有跑。
安装 1.0.1 → 对技能目录跑 quality-check → 再跑 harness-check → 对照两份样本的分数和加载结果
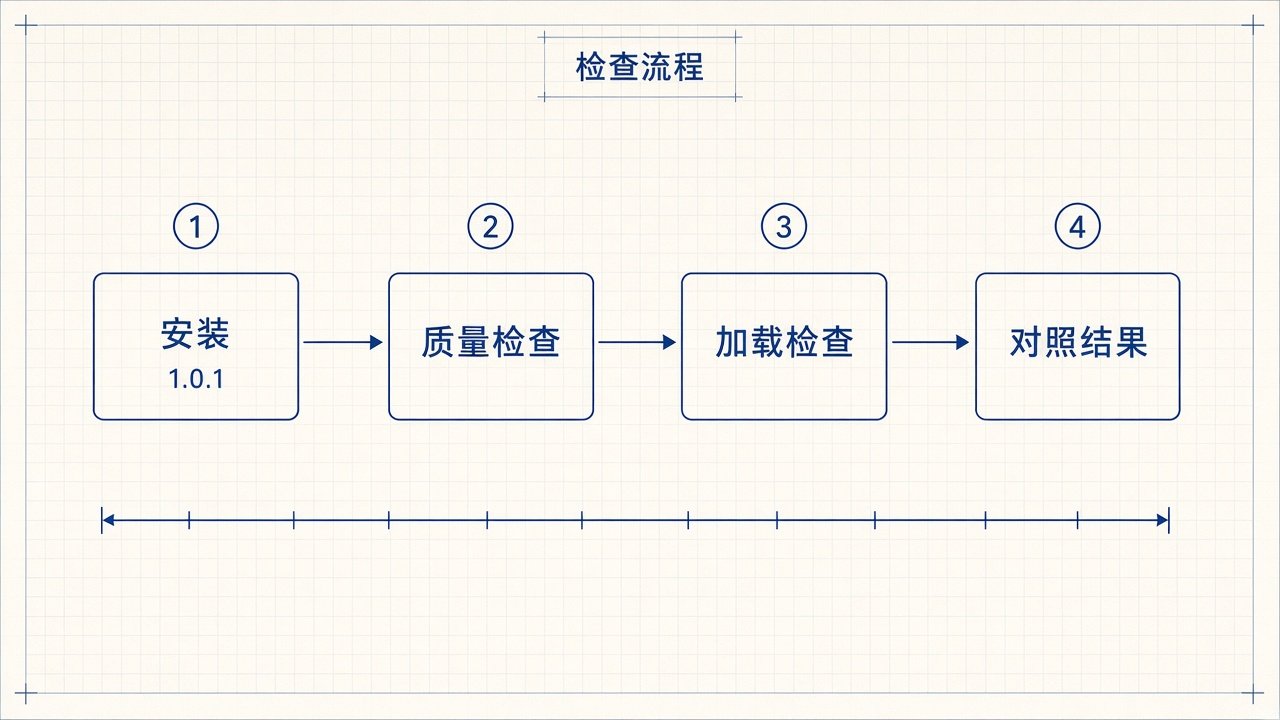
▲ 检查流程:安装 1.0.1 → 质量检查 → 加载检查 → 对照结果。图为蓝图示意,具体命令和分数见后文实测。
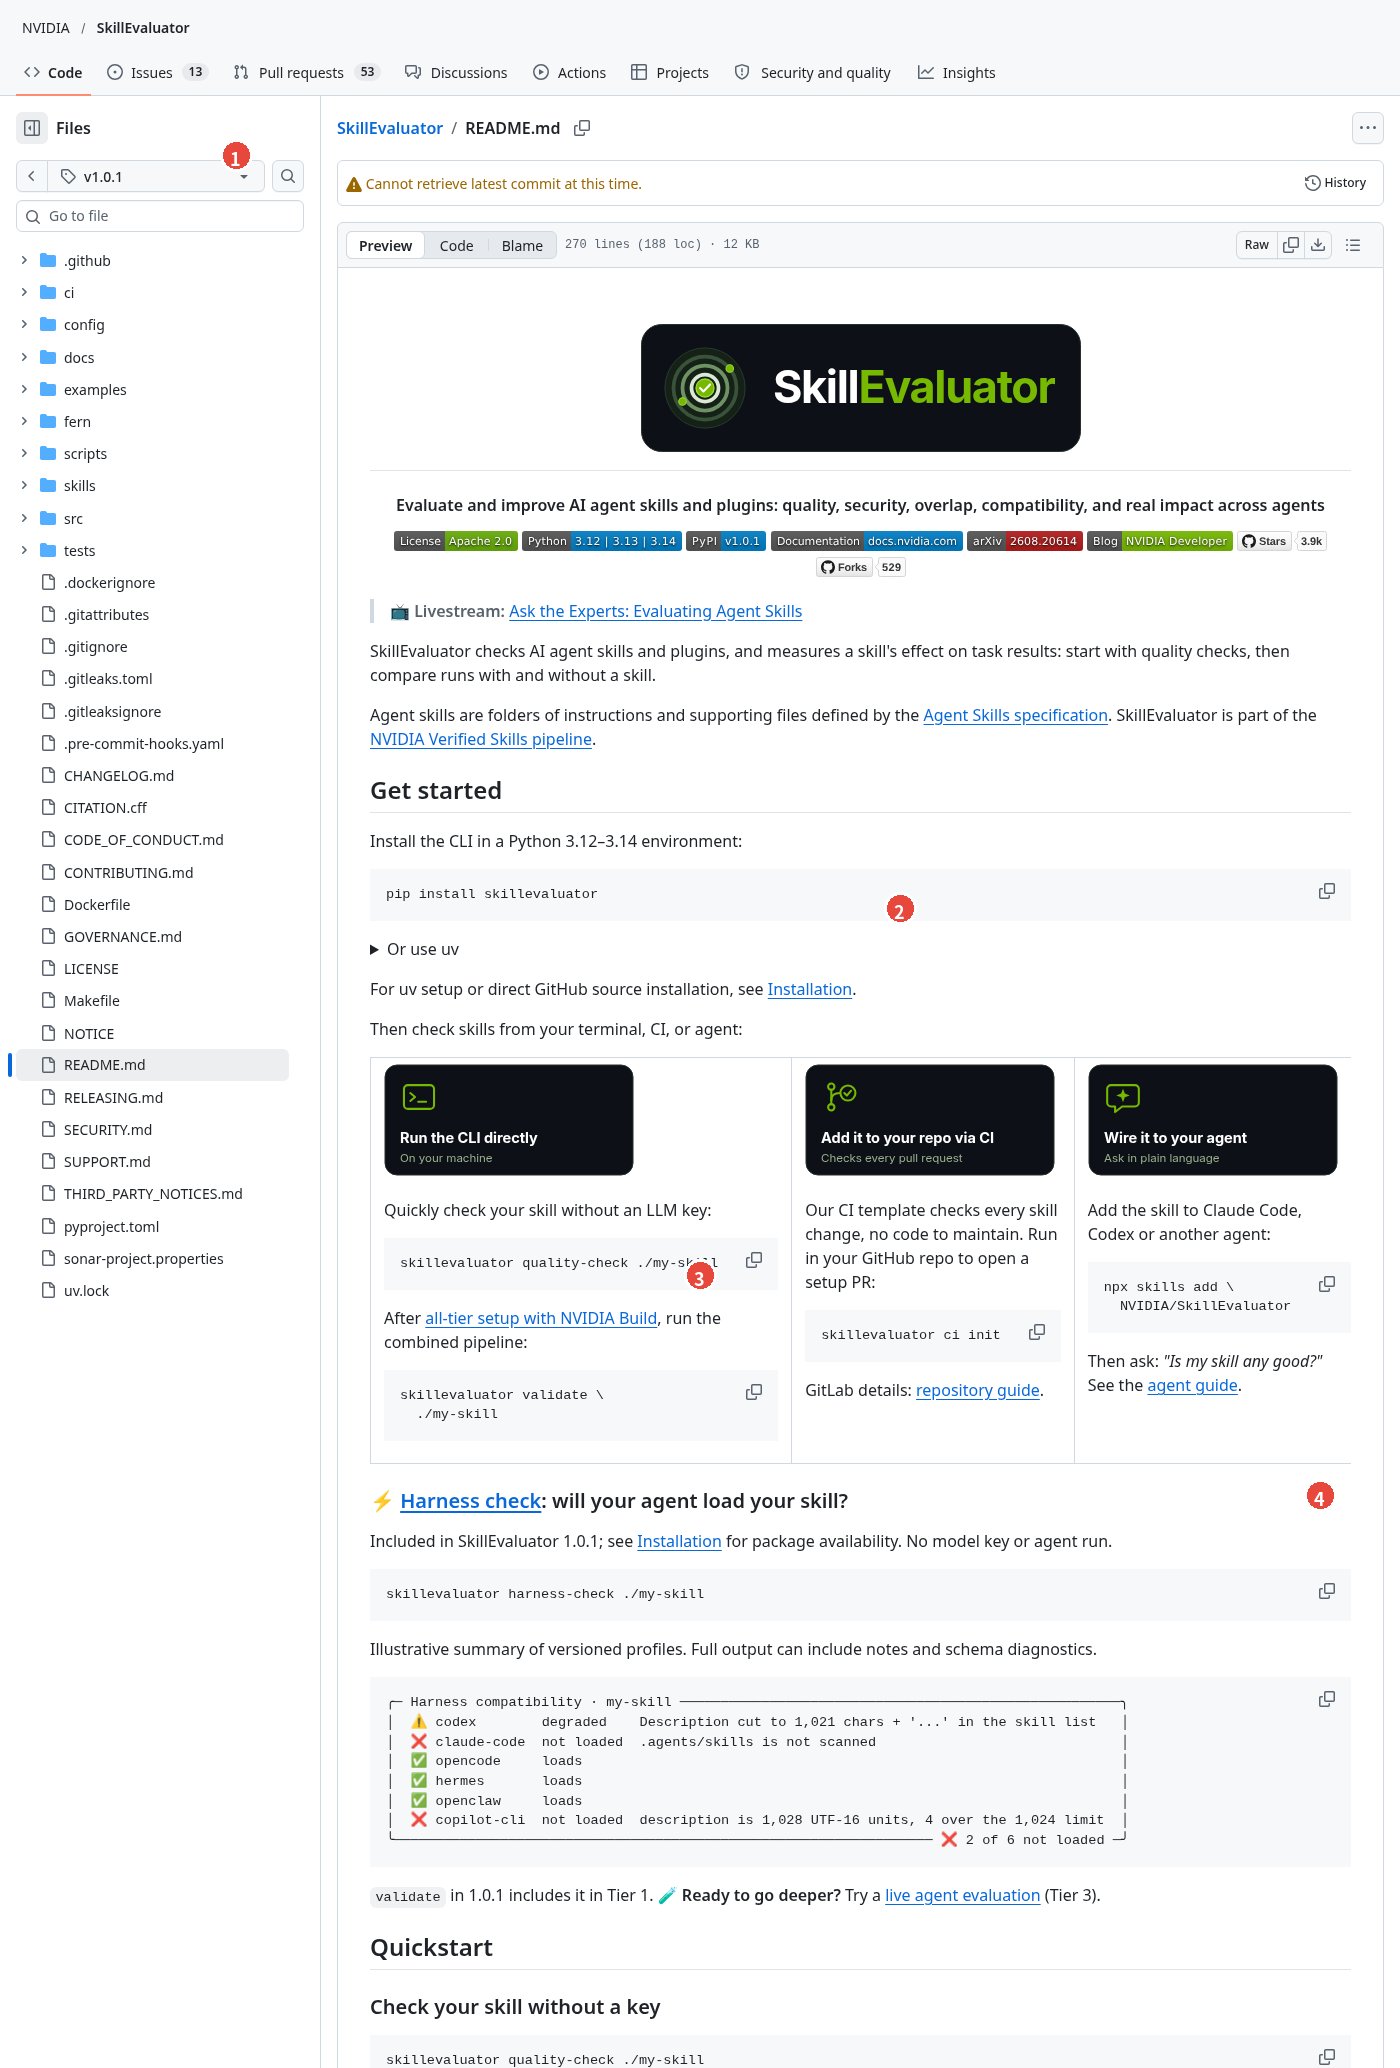
▲ 截自官方仓库标签 v1.0.1 下的 README.md。① 当前标签是 v1.0.1;② 安装示例是 pip install skillevaluator,也可用 uv;③ quality-check 写明不需要 LLM 钥匙;④ harness-check 写明不需要模型钥匙,也不实际启动助手。同一页还写了,跑完整的 validate 要先做 all-tier setup with NVIDIA Build。来源:GitHub 官方页面。拍摄时页面上方有一条 GitHub 自己的提示「Cannot retrieve latest commit at this time」,不影响标签和正文。
PART 01
它解决什么问题,边界在哪
按官方文档的分层,它会检查说明和结构是否合格、助手会不会加载、内容会不会重复,以及在真实任务里有没有帮上忙。仓库在 NVIDIA/SkillEvaluator,许可证是 Apache-2.0,文档在 docs.nvidia.com/skills/skillevaluator。
2026 年 11 月 19 日下午 2 点 52 分(北京时间)前后,GitHub 趋势总榜上它排在第 5,页面写着当天加了 312 星,接口读到的总星数是 3,875。写稿前我又查了一次接口,总星数是 3,882,forks 是 530,最近一次推送换算过来是当天下午 3 点 03 分。这些数字会变,只能作为当时的记录。
本次只用了两道不需要钥匙的检查。质量检查按正确性 35%、可发现性 25%、可靠性 25%、效率 15% 加权,打出 0 到 100 的分数和等级,并列出发现项。加载检查覆盖 Claude Code、Codex、Copilot CLI、Hermes、OpenClaw、OpenCode 六种配置,结果是建议性的:命令退出码仍是 0,不会因为「降级」而当成失败。官方还写了,只跑质量检查时,发布资格会显示为 Incomplete,因为安全扫描、去重和现场评测都不在这道命令里。
一份 2026 年 8 月 19 日的 NVIDIA 技术博客 介绍过完整三层和现场评测里的 Skill Lift。那是更早的介绍,不是这次 1.0.1 的发布说明。要把技能对任务结果的影响测出来,仍然需要钥匙、数据集和沙箱,我这次没有走那一步。
PART 02
在 Linux 上安装 1.0.1
官方文档给的环境是 Python 3.12 到 3.14。我的测试机是 3.13.5,落在这个范围内。为了不碰系统里的其他包,我新建了一个虚拟环境再安装指定版本:
uv venv --python 3.13 .venv
source .venv/bin/activate
uv pip install skillevaluator==1.0.1
skillevaluator --version
安装结束后,包列表里是 skillevaluator==1.0.1,命令行打印 skillevaluator, version 1.0.1。用 Python 读到的发行版本也是 1.0.1。官方还写了 pip install skillevaluator,以及 uv tool install --python 3.13 skillevaluator,这两条我没有另外走一遍,效果应以你本机实际安装为准。
官方示例技能在仓库里的路径是 src/skillevaluator/tier3/reference_skills/text-analyzer。我按标签 v1.0.1 做了浅克隆,确认这个目录里有 SKILL.md、scripts 和 evals。第二份样本只要是一份带 SKILL.md 的技能目录即可。我复制了 last30days 的目录,同样先确认了 SKILL.md 在。
如果你只想先看命令帮助,可以运行:
skillevaluator quality-check --help
skillevaluator harness-check --help
质量检查默认及格线是 --min-score 70,报告默认打在终端上。加载检查默认覆盖全部内置助手配置;--json 可以再留一份机器可读结果。它还有一个 --context-tokens,用来告诉检查器你实际使用的上下文窗口。我不传这个参数时,它按「未知,则按最小窗口」来算。后面 OpenClaw 的降级,和这条默认规则有关。
PART 03
先给官方示例做质量检查
在示例目录的上一级执行:
skillevaluator quality-check ./text-analyzer2026 年 11 月 19 日 14 点 55 分 26 秒(北京时间),这次检查跑了 0.825 秒,状态是 PASS。总分 88.8,等级 B,技能类型被标成 script-based。四个分项是:正确性 75、可发现性 95、可靠性 95、效率 100。发现项 5 条,其中中等 3 条、低 2 条,没有高或严重项。
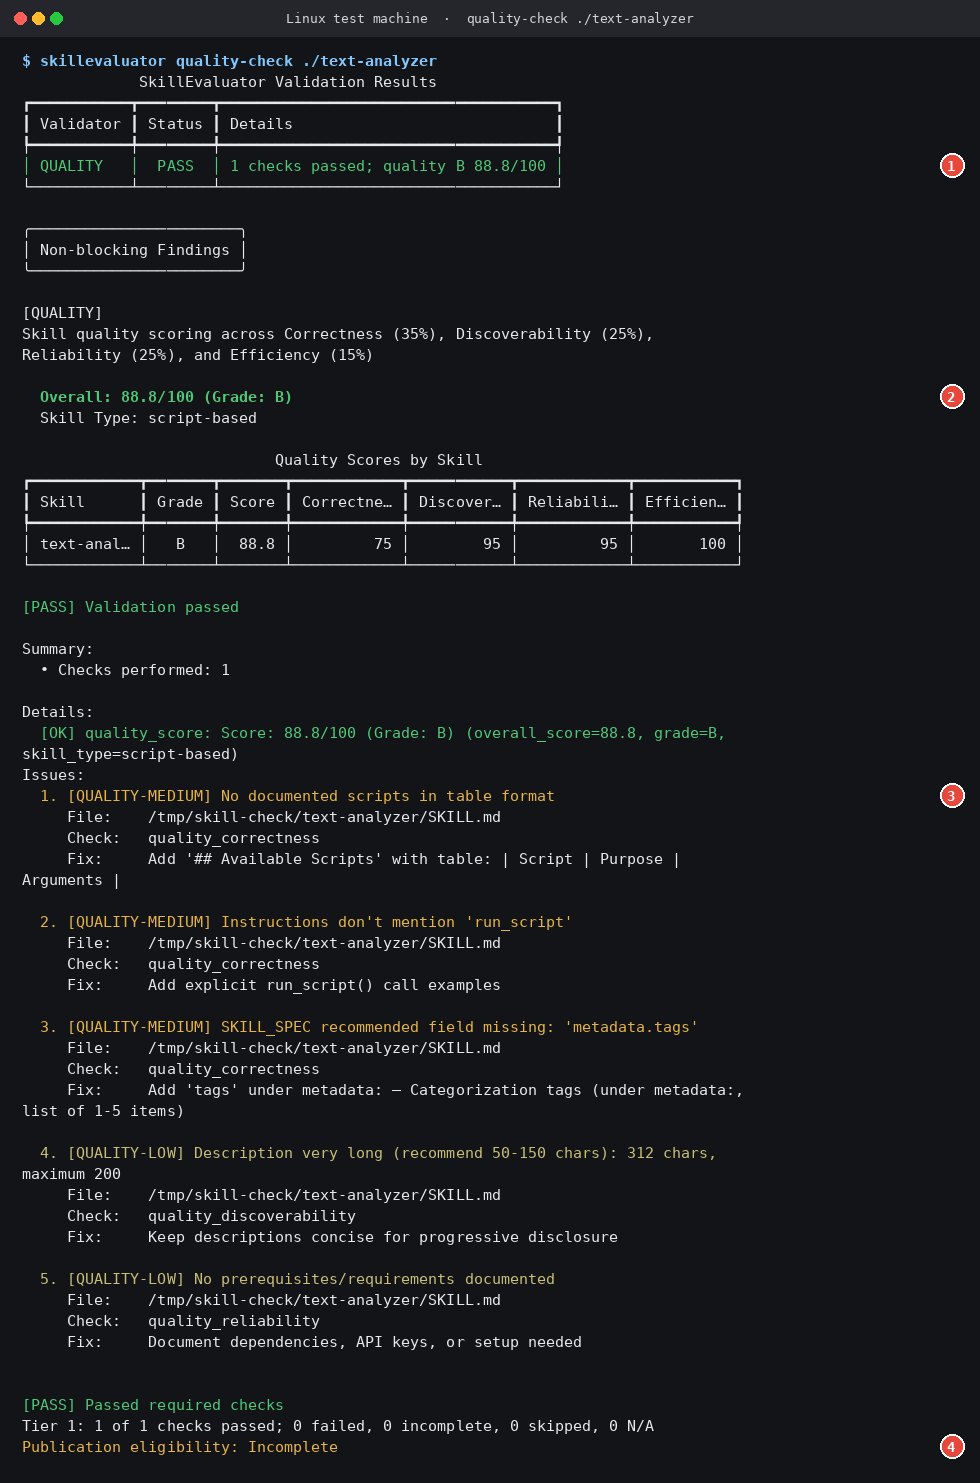
▲ 我在 Linux 测试机上对 ./text-analyzer 执行 skillevaluator quality-check 的完整输出。① 状态是 PASS,质量 B 88.8/100;② 四个分项里效率是 100,正确性最低,是 75;③ 前几条发现项集中在脚本表格、run_script 示例和 metadata.tags;④ 发布资格是 Incomplete,因为这次只跑了质量检查。
三条中等发现项都落在正确性上:说明里没有用表格列出可用脚本、正文没写 run_script 的调用示例、frontmatter 里缺少建议字段 metadata.tags。两条较低的发现项是:描述有 312 个字符,超过它建议的 50–150 字、上限 200 字;另外没有单独写出前置条件。效率这项没有扣分。报告里估算的 token 是 479,远低于它提到的 5,000 上限。SKILL.md 本身是 62 行、1,916 个字符。
官方 README 也提醒过,示例技能的分数可能随版本变化。上面这些数字只对应 1.0.1 里这份 text-analyzer。得了 B 的同时,这 5 条发现项仍然写在报告里。
PART 04
再看六个助手会不会加载它
同一份目录,接着跑:
skillevaluator harness-check ./text-analyzer -v这次用了 0.459 秒,结尾是「6 of 6 load」。Claude Code(核实版本 2.1.316)、Codex(0.166.0)、Copilot CLI(1.0.105)、Hermes(main @ c419cf7c864a,二进制报 2026.9.24)、OpenClaw(2026.10.9)、OpenCode(1.19.5)全都是 loads。这些版本号是检查器配置文件里核实过的版本,不是我本机安装的助手版本。我没有真正打开这六个助手去加载技能。
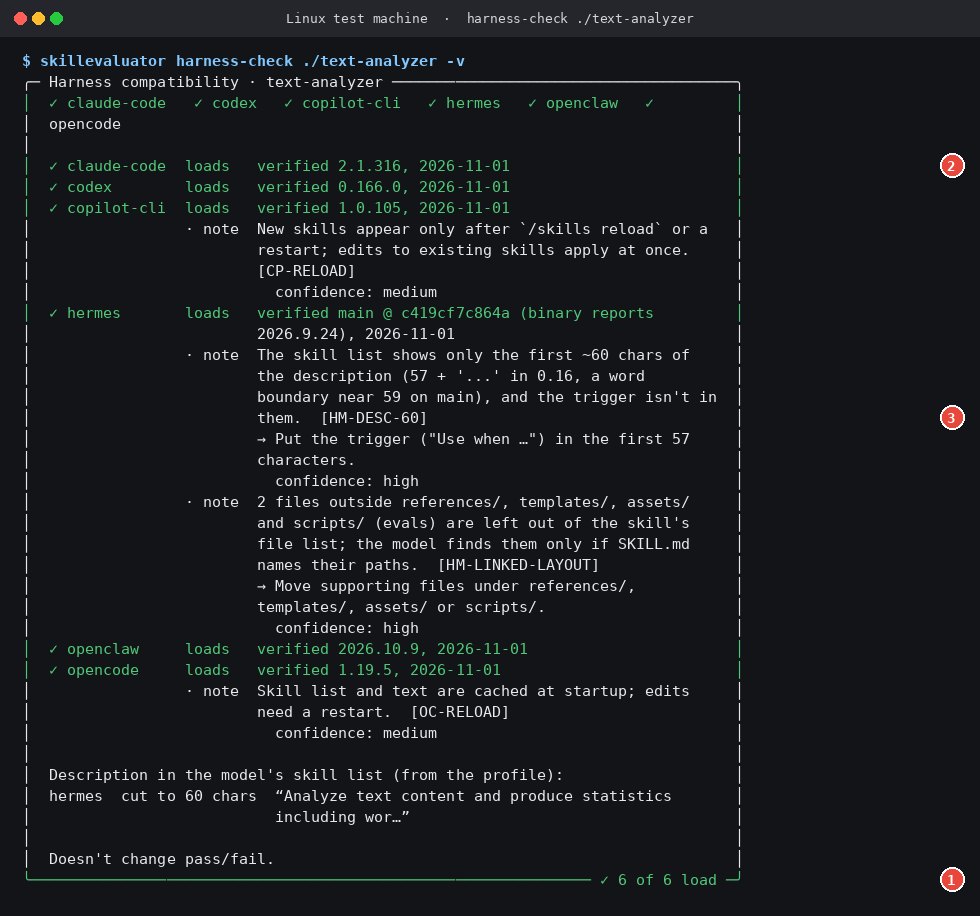
▲ skillevaluator harness-check ./text-analyzer -v 的输出。① 结尾是 6 of 6 load;② 六个配置的状态都是 loads,并注明了核实版本和日期 2026-11-01;③ Hermes 仍有一条说明:技能列表里只展示描述的大约前 60 个字符,而触发语不在这截里,建议把 “Use when …” 放到前 57 个字符。这条说明不改变通过或失败。
「全部加载」不等于没有任何备注。Copilot CLI 提到,新技能要执行 /skills reload 或重启后才会出现。Hermes 除了描述截断,还提到 evals 目录不在它默认收录的 references/、templates/、assets/、scripts/ 里,模型只有在 SKILL.md 写了路径时才会找到。OpenCode 则提示,技能列表和文本在启动时缓存,改完需要重启。这些都标成 note,没有把状态改成降级。
PART 05
用同一套命令检查一份真实技能
官方示例偏短,说明也相对完整。为了看同一套命令碰到真实技能目录会怎样,我复制了 last30days 的技能文件夹,确认其中有 SKILL.md,然后执行:
skillevaluator quality-check ./last30days
skillevaluator harness-check ./last30days -v
质量检查在 14 点 55 分 36 秒开始,用了 1.055 秒,状态同样是 PASS。总分 78.5,等级 C,类型是 hybrid。四个分项是:正确性 70、可发现性 80、可靠性 85、效率 85。发现项 11 条,中等 5 条、低 6 条。因为它仍高于默认的 70 分及格线,所以没有判失败。
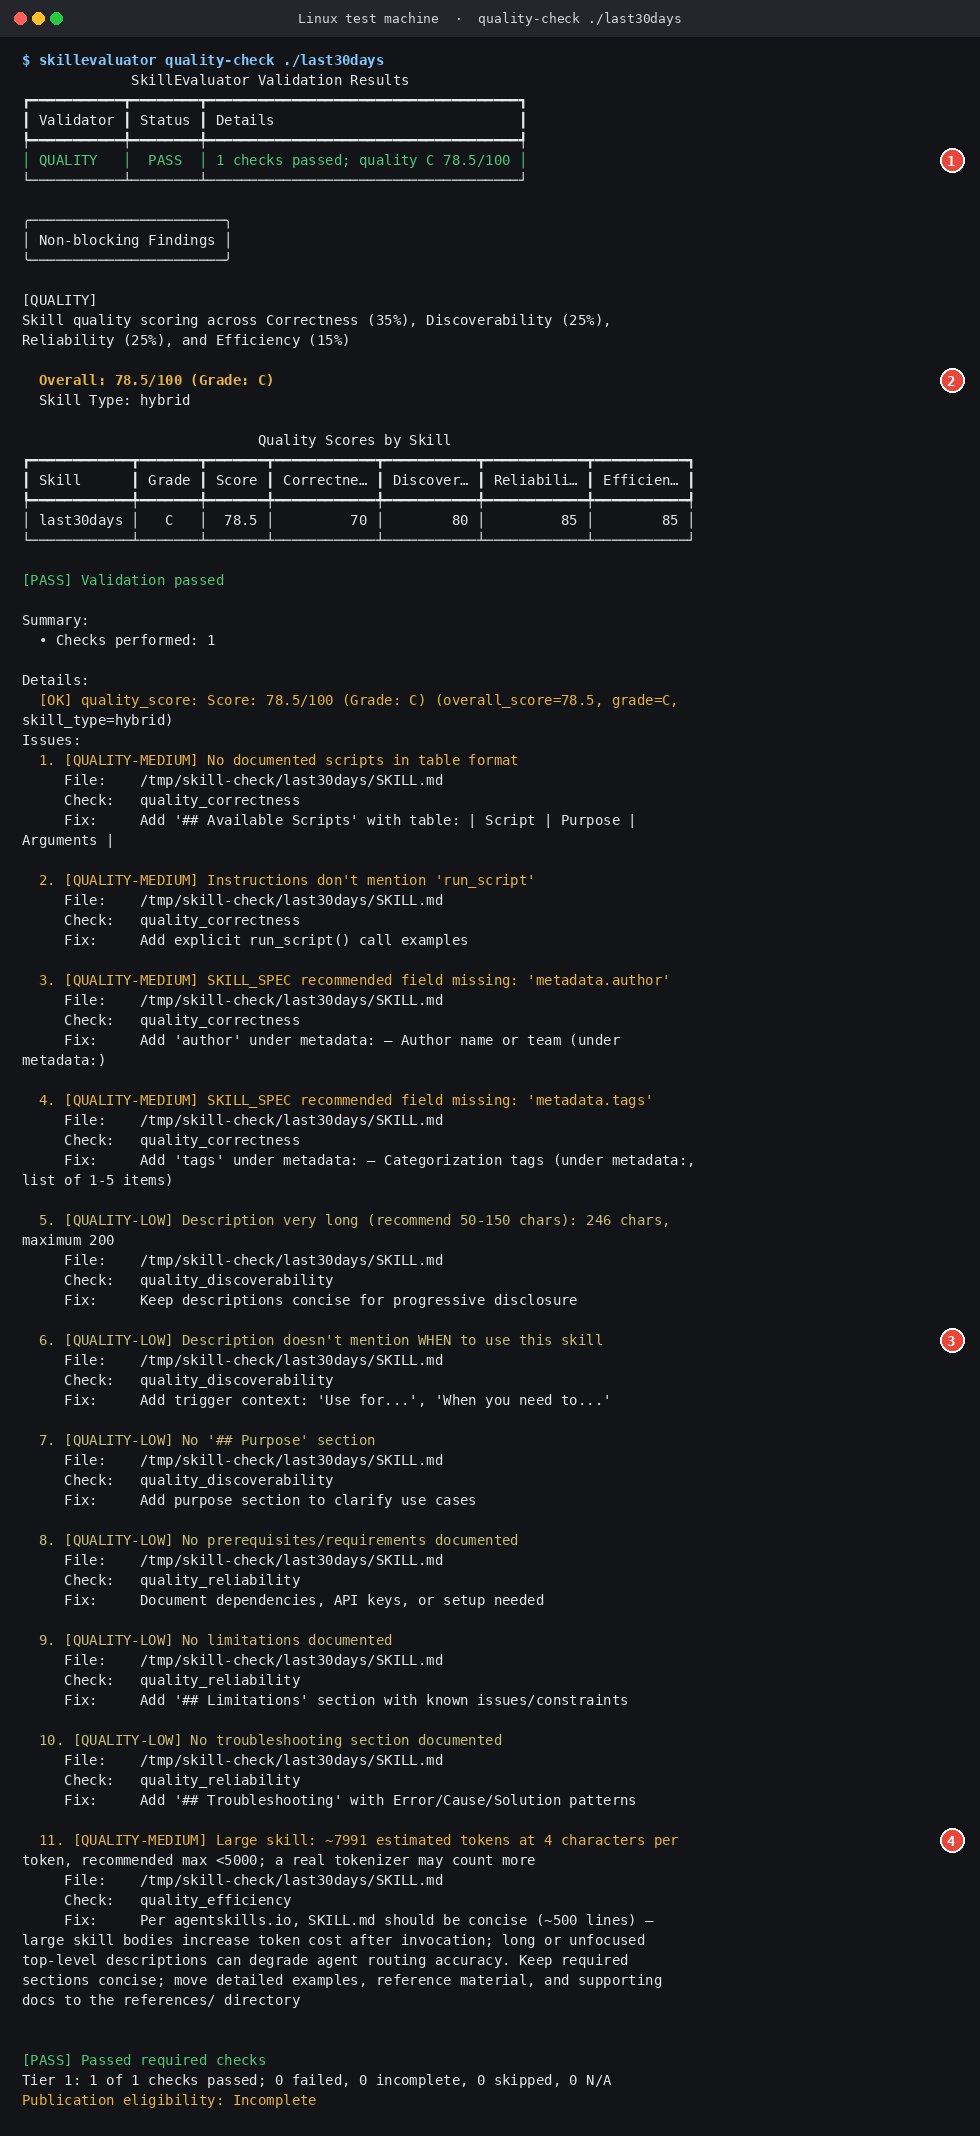
▲ 对 ./last30days 执行 quality-check 的完整输出。① 状态是 PASS,质量 C 78.5/100;② 正确性 70,是四个分项里最低的;③ 第 6 条指出描述里没有写何时使用该技能;④ 第 11 条指出估算约 7,991 个 token,超过建议的 5,000。
11 条里,有几条对改技能更直接。正确性扣分包括:没有用表格列出脚本、正文没写 run_script、缺少 metadata.author 和 metadata.tags。我打开这份 SKILL.md 时,文件开头其实写了 author: mvanhorn,但它不在 metadata: 下面,检查器就不认。可发现性里,描述是 246 个字符,同样超过建议长度;它还明确写了「Description doesn’t mention WHEN to use this skill」,建议补上 “Use for…” 或 “When you need to…”。可靠性则提到缺少前置条件、限制和故障排查小节。效率那条说,按每 4 个字符估 1 个 token,这份技能大约 7,991,超过建议上限 5,000,并提醒真实分词器可能会更高。我按普通字符计,SKILL.md 是 31,967 个字符、263 行。
加载检查用了 0.487 秒,结尾是「1 of 6 degraded」。Claude Code、Codex、Copilot CLI、Hermes、OpenCode 仍是 loads,OpenClaw 是 degraded。这次我没有传 --context-tokens,检查器按最小窗口来算。
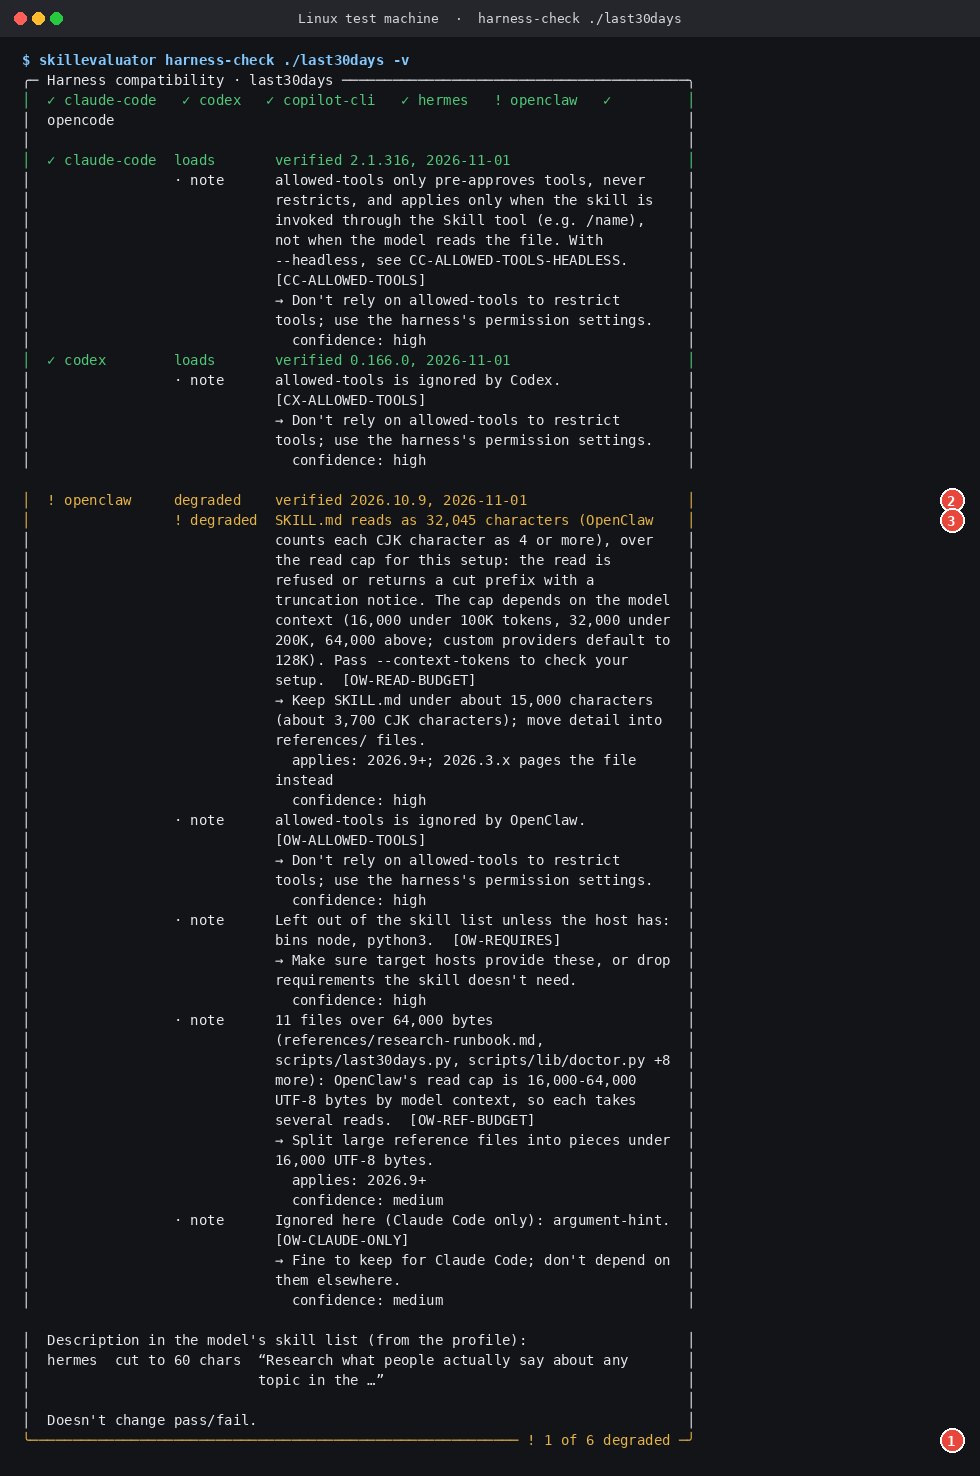
▲ harness-check ./last30days -v 的输出节选,保留了开头总览和 OpenClaw 这一段,中间其他助手的部分说明有省略。① 结尾是 1 of 6 degraded;② OpenClaw 的状态是 degraded,核实版本 2026.10.9;③ 主要原因写在 OW-READ-BUDGET:按 OpenClaw 的计数,SKILL.md 是 32,045 个字符(中日韩字符会按 4 或更多计),超过当前设定的读取上限。建议把正文压到大约 15,000 个字符,细节挪到 references/。图中也写了,上限取决于模型上下文,可用 --context-tokens 按自己的实际窗口再查一次。
这条降级需要读完整。检查器写得很清楚:在未知上下文时,它按最小窗口处理;100K 以下窗口的读取上限是 16,000 字符,200K 以下是 32,000,再往上是 64,000。32,045 这个计数已经超过 16,000,也略高于 32,000。如果你实际用的窗口更大,应该把真实的 --context-tokens 传进去再跑一遍,结果可能不同。我这次没有做这个加测,所以只能报告默认设定下的结论:OpenClaw 为降级,其余五个为加载。
即便是显示为加载的助手,也还有说明性备注。例如多个配置都提到,allowed-tools 并不会真正限制工具;Hermes 同样截断了描述的前约 60 个字符,而「何时使用」并不在这截里。这些备注不改变「1 of 6 degraded」这个总结果,但改描述时值得一起看。
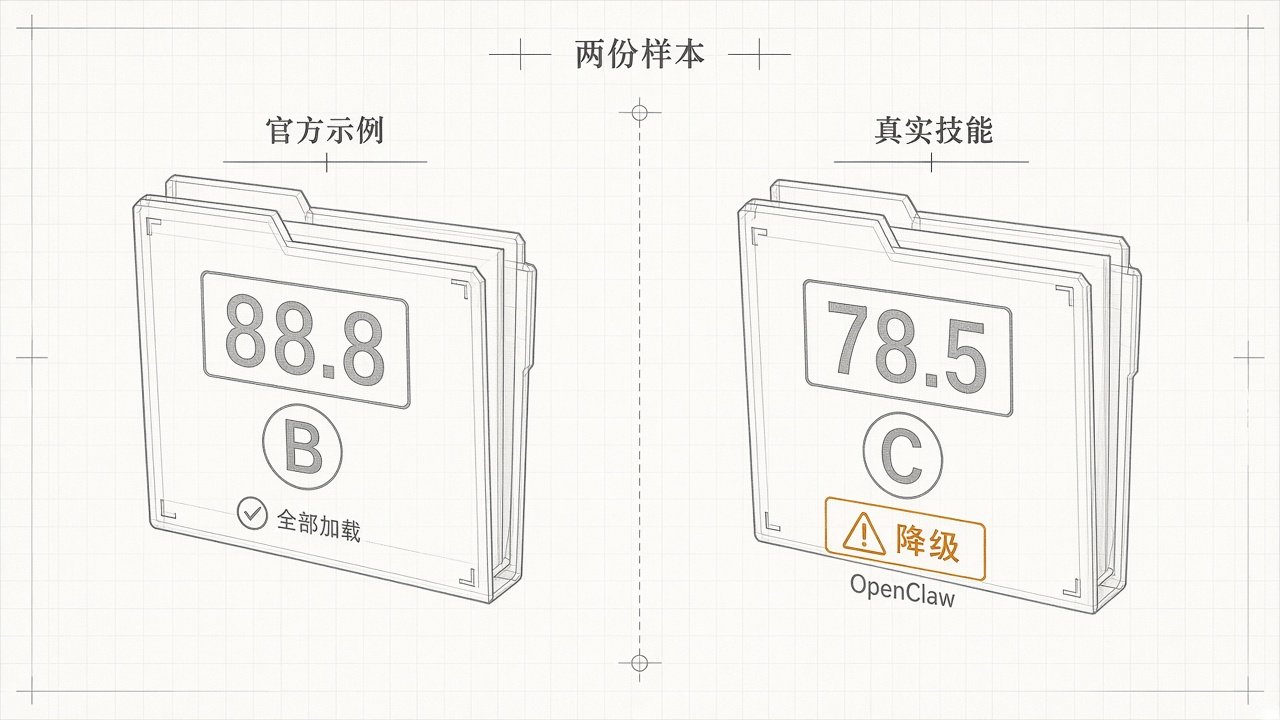
▲ 两份样本对照示意。左边是官方示例 text-analyzer:88.8 分,等级 B,六个助手全部加载;右边是真实技能 last30days:78.5 分,等级 C,OpenClaw 为降级。分数和状态来自本次 1.0.1 实测,详细输出见上文终端截图。
PART 06
这两道检查看不出什么,以及我没跑的部分
质量检查看的是技能目录写得如何,加载检查看的是按内置配置会不会被读到。它们都很快,这次四次调用都在大约 0.5 到 1.1 秒之间。它们不能代替现场评测:既不会启动 Claude Code 或 Codex 去完成真实任务,也不会给出「有技能 / 没有技能」的对照分。
这次没有跑的命令包括:skillevaluator validate(官方写明要先完成 NVIDIA Build 的全层准备)、tier2 去重、tier3 现场评测,以及 security-scan、pii-scan、rubric-eval 等。我没有注册 NVIDIA Build,也没有使用模型钥匙去跑这些层。官方在只做质量检查的报告末尾写了 Publication eligibility: Incomplete,原因包括代码完整性、许可证、脚本检查、PII、schema、安全、Unicode、版本等项未跑,也缺少第二层和第三层的完整证据。这个 Incomplete 是预期结果,不是安装失败。
如果要自己复现这次两道检查,准备好 Python 3.12–3.14、一份带 SKILL.md 的技能目录,然后安装 1.0.1,按上面的命令执行即可。若要核对某个助手在你常用上下文窗口下的读取上限,把 --context-tokens 加上再跑加载检查。想看技能会不会真的把任务做对,还得走官方的现场评测流程,那一步需要另外的准备,不在这篇的实测范围里。
相关阅读:之前写过 别只拿 AI 写文案了:剪视频、加字幕,这个开源工具也能做,以及 让 AI 写代码前先问清楚:Matt Pocock 的 skills 安装和使用教程。本文只检查技能目录的质量和加载情况,没有把技能装进某个正在对话的助手里实测调用。






