

共计 5822 个字符,预计需要花费 15 分钟才能阅读完成。
版本、预览和未配置时的报错以我在 Linux 测试机上的输出为准。完整的 ocr review 需要配置模型,本文没有录入 API Key,也没有跑通带模型的审查。
AI 写完一段代码,我想先审一审,但不想立刻把 API Key 交给一个刚装上的新工具。今天 GitHub 日榜靠前的 Open Code Review,正好把这件事拆开了:先看它打算审哪些文件、会套哪一组规则;精确到行的评论,要等模型配好再做。
Open Code Review 是阿里开源的代码审查命令行工具,命令是 ocr。仓库在 alibaba/open-code-review,协议 Apache-2.0,项目主页是 https://open-codereview.ai。我在 2026-11-14 15:02(北京时间)用 GitHub API 读到 50,848 星。当天多家 GitHub 日榜归档把它排在很靠前的位置。X 上也有人把这批上榜项目放在一起聊,我只把那些帖子当成发现入口,版本、命令和限制以官方文档和本机输出为准。
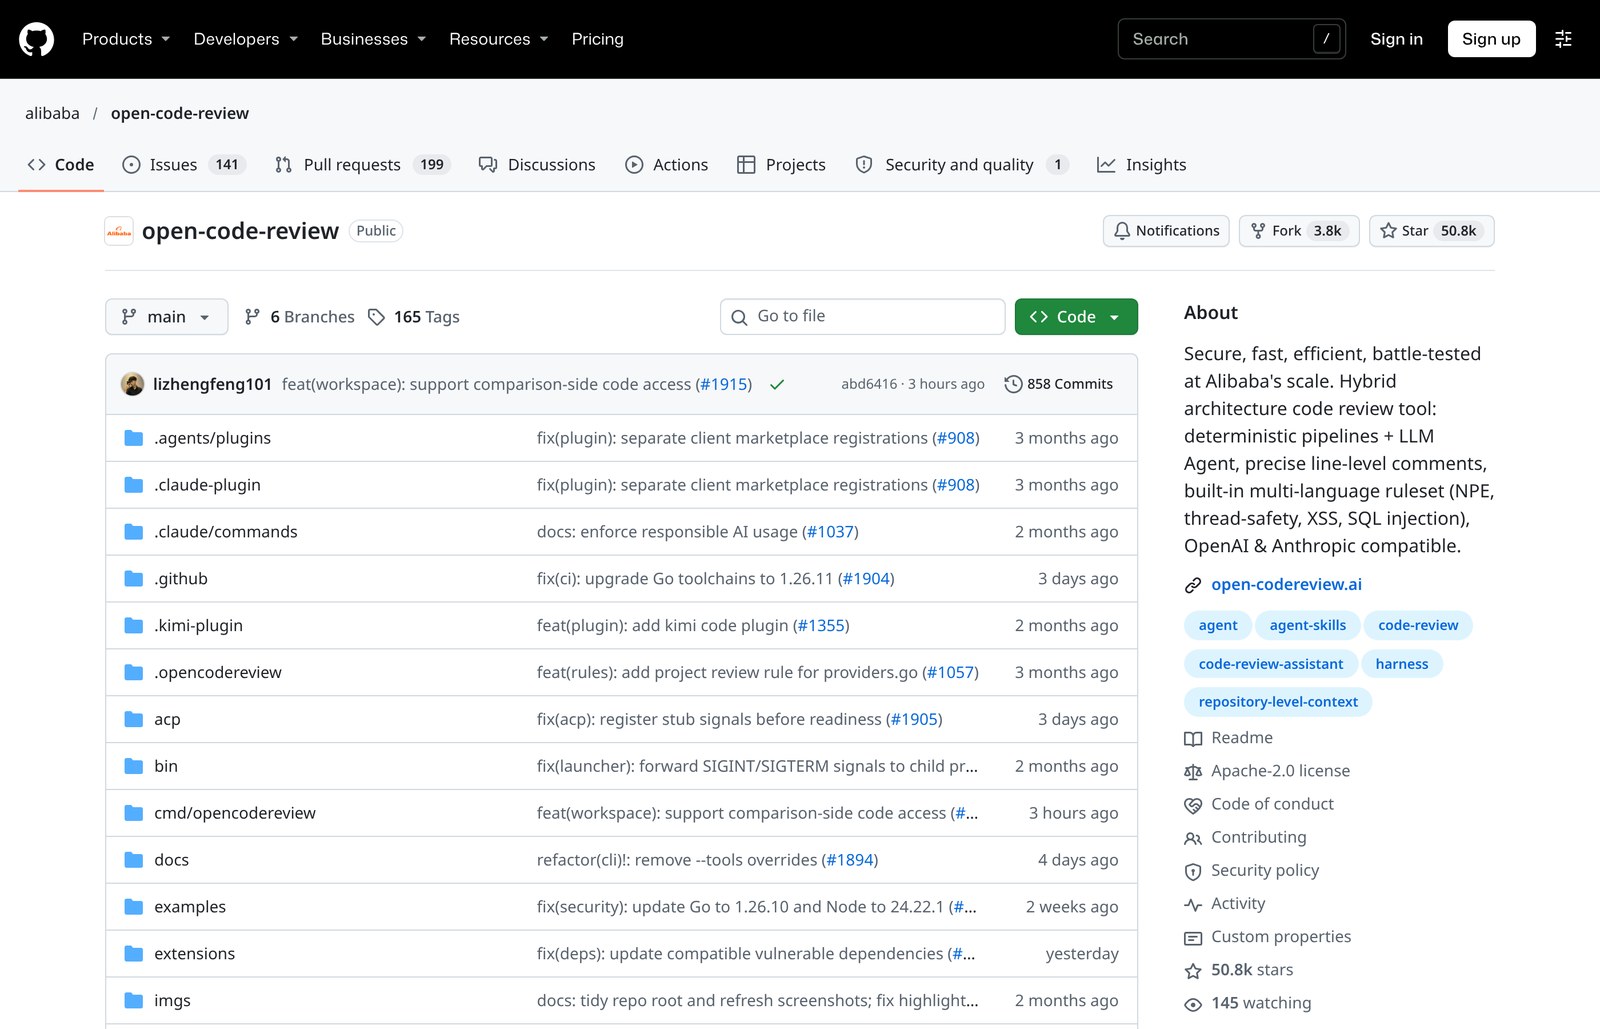
▲ GitHub 仓库 alibaba/open-code-review。截图来源:github.com,作者测试机,北京时间 2026-11-14 15:03。当时页面右上角星数显示为 50.8k,与我用 API 读到的 50,848 一致。
· · ·
PART 01
它做什么,要解决什么
按中文 README的说法,Open Code Review 读取 Git 的 diff,把变更交给可配置的大模型 Agent,再给出精确到行的审查意见。它也能用 ocr scan 审整个文件,而不只看这次改了什么。
项目方把一个常见问题写得很直白:直接让通用编程 Agent 审代码,变更一大就容易漏文件,报告里的行号有时对不上,审查质量还会跟着提示词上下晃。Open Code Review 的做法是把「审哪些文件、套哪条规则」交给程序来做,模型主要负责理解和判断。仓库简介里提到,内置规则覆盖多门语言,类别名称包括空指针(NPE)、线程安全,以及 XSS、SQL 注入这类安全项。类别只转述名称,本文不展开利用方式。
中文 README 还写:它的前身是阿里集团内部的官方 AI 代码审查助手,过去两年在内部服务了数万开发者,识别了数百万个代码缺陷。这是项目方自己的表述,我没有独立核实。
官网文档是前端页面,用普通抓取不容易抽出正文。下面引用的安装、快速开始、配置和委托模式说明,以仓库里的中文源文件为准;需要点开官网时,可以用这些地址:安装、快速开始、配置、委托模式。
· · ·
PART 02
两种用法:一种要配模型,一种不用
我在本机把这两条路都对照文档跑了一遍入口命令。差别很清楚。
ocr review 和 ocr scan 会由 Open Code Review 自己调用已配置的大模型,给出行级评论。这条路必须先配模型。官方快速开始写的步骤是:
ocr config provider → ocr config model → ocr llm test → 再运行 ocr review
委托模式走另一条路。委托模式文档写明:Open Code Review 只做文件筛选和规则解析,真正的判断交给宿主编程 Agent 自己的模型,OCR 这边不必配置 API Key。入口命令是:
ocr delegate preview 看会审哪些文件 → ocr delegate rule 看会套哪组规则 → 由宿主 Agent 用自己的模型做判断
ocr review --help 里,v1.13.9 仍然带 --preview(短选项 -p),说明是「只预览将要审查的文件,不调用大模型」。我后面实际跑通了它。
🍎 不配模型,就不要指望看到完整的行级评论。ocr review 没有有效端点时会直接报错退出。只想先看范围,用 ocr delegate preview 或 ocr review --preview。
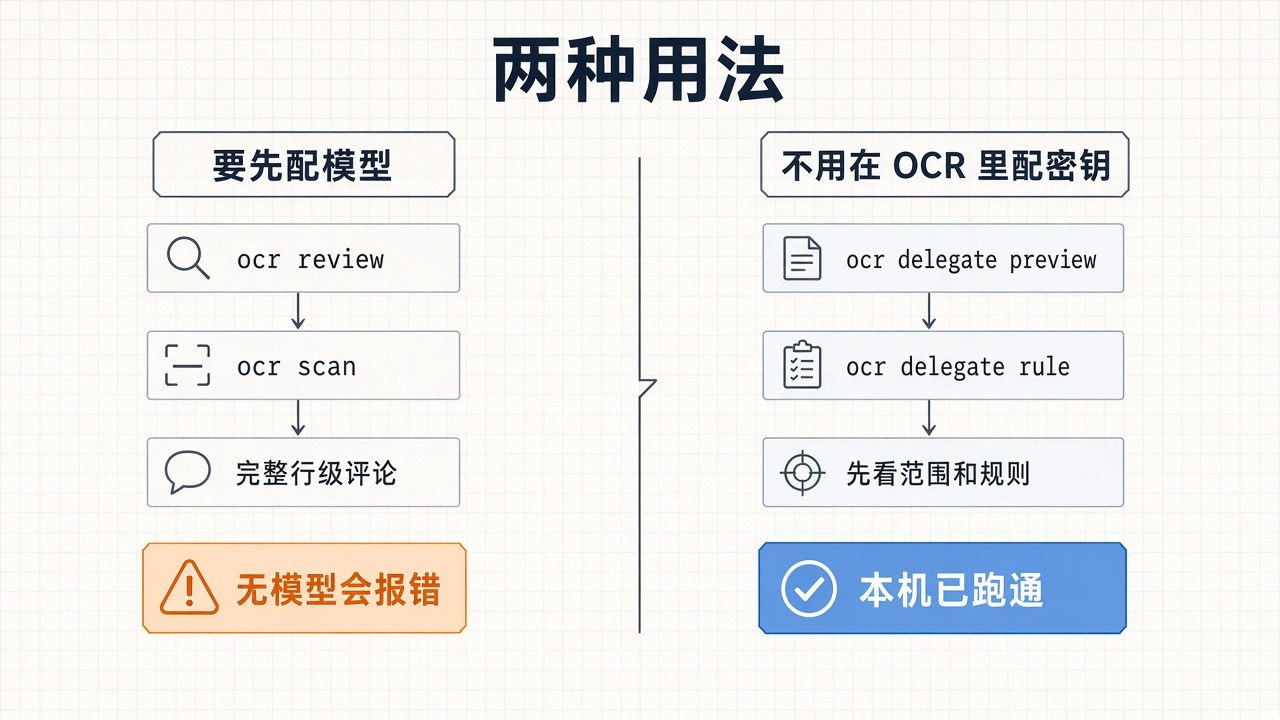
▲ 示意图:两种用法的差别。蓝图示意,不代表真实软件界面。
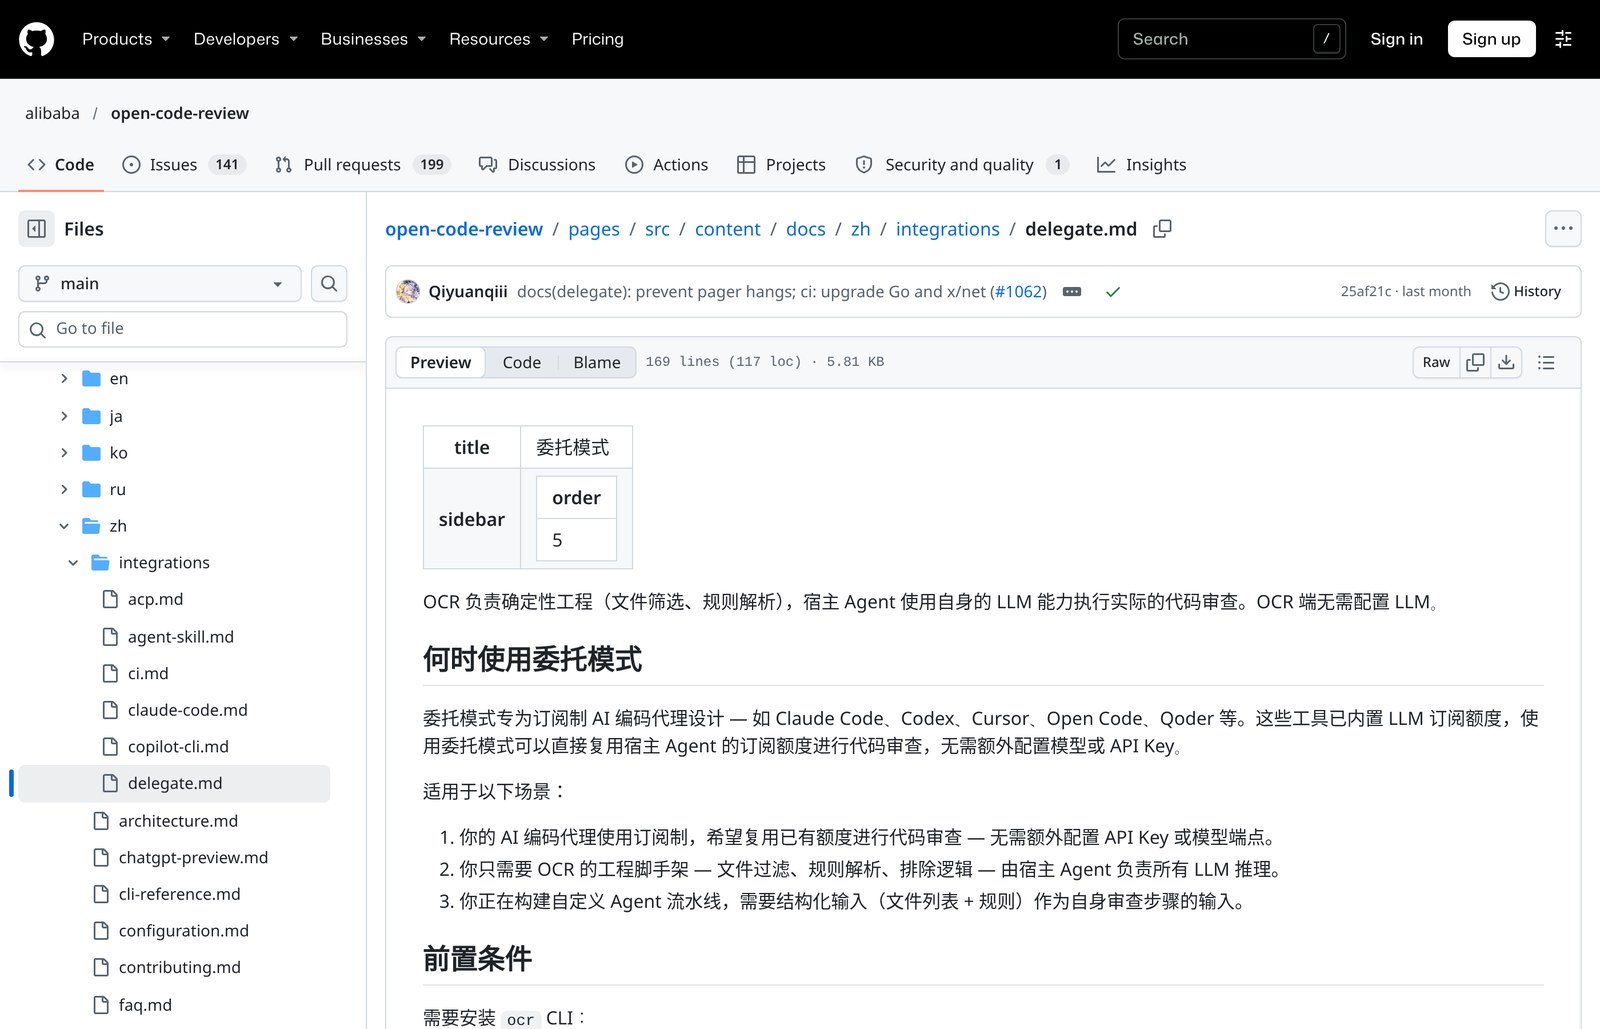
▲ 仓库里的中文文档 pages/src/content/docs/zh/integrations/delegate.md。截图来源:github.com,作者测试机,北京时间 2026-11-14 15:03。官网对应页面是 https://open-codereview.ai/docs/delegate。
· · ·
PART 03
我在 Linux 上装到了 v1.13.9
测试机上的环境是:Git 2.47.3、Node v24.22.1、npm 11.21.1。官方前置条件是 Git 不低于 2.41,这一点满足。当时机器上还没有全局的 ocr 命令,也没有 ~/.opencodereview/ 配置目录。
官方推荐的安装方式是:
npm install -g @alibaba-group/open-code-review我没有走全局 npm,而是从 GitHub Release v1.13.9 下载了 Linux x86_64 静态二进制 opencodereview-linux-amd64,并同时下载了同一页提供的 sha256sum.txt。校验结果是 opencodereview-linux-amd64: OK,哈希值为:
2db294981624d6fae9bcfb4df7f9ebfd7f92c40b3a552873dff5887116931d3e同一时刻,npm view @alibaba-group/open-code-review version 的结果也是 1.13.9,和这个 Release 一致。我把二进制放到测试机的本地目录,做成名为 ocr 的可执行命令,加入当前会话的 PATH,并设置了 OCR_NO_UPDATE=1。官方安装文档写:通过 npm 安装时,程序默认会在后台检查更新;把 OCR_NO_UPDATE 设成非空值可以关掉。静态二进制本身不走这套自动更新,我还是按文档把这个变量设上了。
下载 v1.13.9 的 opencodereview-linux-amd64 → 用官方 sha256sum.txt 校验 → 放到本地目录并加入 PATH → 设置 OCR_NO_UPDATE=1 → 运行 ocr version
ocr version 的全文是:
open-code-review v1.13.9 (0e9060d) linux/amd64
built at: 2026-11-13T09:14:32Z
https://github.com/alibaba/open-code-review
退出码是 0。括号里的 0e9060d 和 Release 页面上的提交一致。built at 这行是 UTC 时间,换成北京时间是 2026-11-13 17:14:32。Release 的发布时间按 GitHub 记录是 2026-11-13 17:47:57(北京时间)。
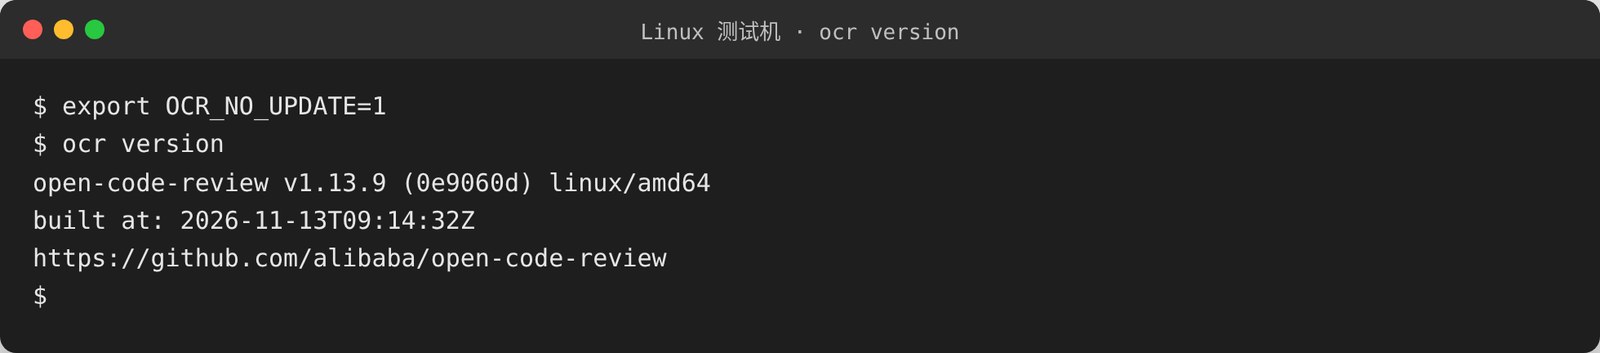
▲ 根据 Linux 测试机上 ocr version 的实际输出整理。北京时间 2026-11-14 15:03。
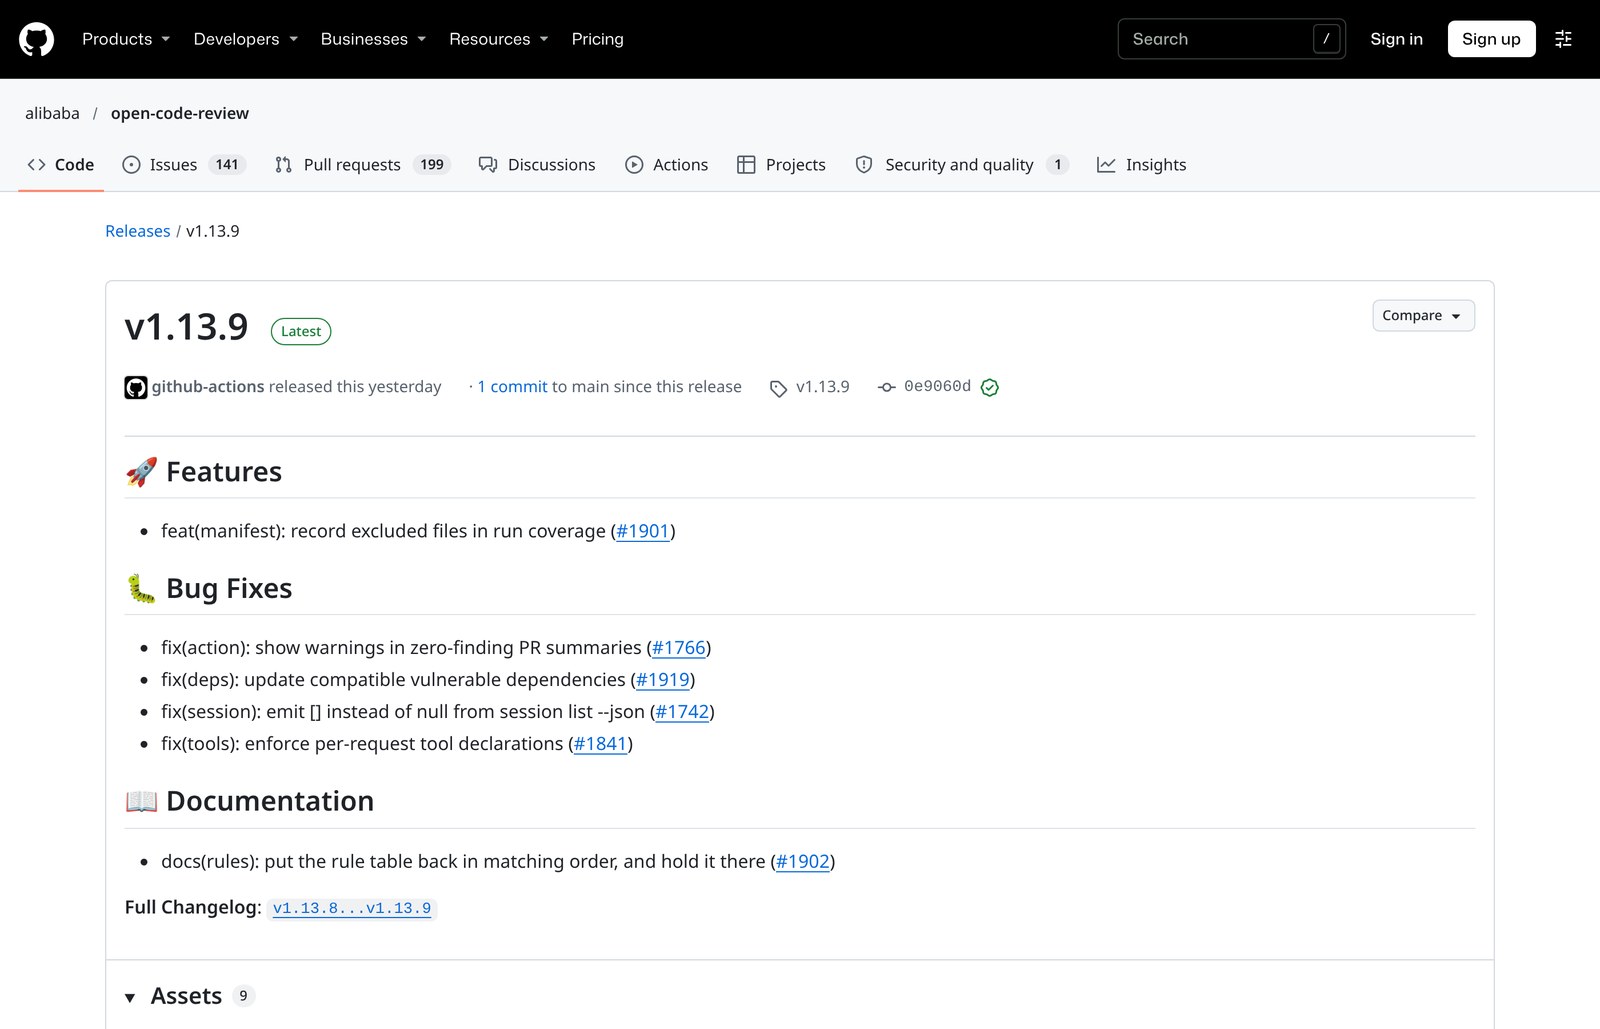
▲ GitHub Release v1.13.9 页面。截图来源:github.com/alibaba/open-code-review/releases/tag/v1.13.9,作者测试机,北京时间 2026-11-14 15:03。页面底部的 Assets 列表当时是收起的,本文不以这张截图清点附件。
发行说明里写了:覆盖率会记录被排除的文件,另外修了若干问题,规则表文档的顺序也改回了和规则匹配一致。这些我没有单独复测,只在安装时核对了版本号和校验和。
ocr --help 可以正常显示顶层命令,里面能看到 review、scan、delegate、config、llm 等子命令,退出码同样是 0。
· · ·
PART 04
自建一个很小的演示仓库
为了看预览到底会选出哪些文件,我在测试机上单独建了一个很小的 Git 仓库,只用来演示,不用于生产。先提交了一份说明,再加入两个新的 Python 文件,放进暂存区,还没有做第二次提交。
user_profile.py 里留了两处浅显问题:读取用户资料时没有先判断对象是否存在,就直接取字段;把字符串转成整数时,也没有处理转换失败。
def display_user(user):
    # 演示缺陷 1:user 可能是 None,这里没有先判断就直接取字段
    name = user["name"].strip()
    email = user["email"].lower()
    return f"{name} <{email}>"

def parse_age(raw):
    # 演示缺陷 2:字符串转整数时没有处理转换失败
    return int(raw)
config_loader.py 里是第三处:打开文件、拆分键值、读取必要字段,都没有处理失败的情况。
def load_settings(path):
    # 演示缺陷 3:打开文件、拆分键值、读取必要字段都没有处理失败情况
    with open(path) as f:
        text = f.read()
    items = {}
    for line in text.splitlines():
        key, value = line.split("=", 1)
        items[key.strip()] = value.strip()
    return items["host"], items["port"]
这三处都是演示用的空值解引用和缺失错误处理,目的只是给预览命令提供一点真实改动。
· · ·
PART 05
没配模型时实际跑通的命令
我在这个演示仓库的目录里,依次跑了预览、规则和一次未配置的 ocr review。
ocr --color never delegate preview 退出码是 0,输出是:
# Files (2 reviewable / 2 total)
- mode: workspace
- total_insertions: 25
- total_deletions: 0
  - `config_loader.py` [added] +12/-0
  - `user_profile.py` [added] +13/-0
它把这次改动识别成工作区模式,两个新文件都在可审查列表里,合计新增 25 行、删除 0 行,和这两个文件的行数一致。
紧接着跑 ocr --color never review --preview,退出码同样是 0:
Preview: 2 file(s) changed  |  +25  -0
Will review (2):
  [A]  config_loader.py     +12   -0
  [A]  user_profile.py      +13   -0
两边选出的文件和行数相同。到这一步,仍然没有调用模型,也没有写出行级评论。
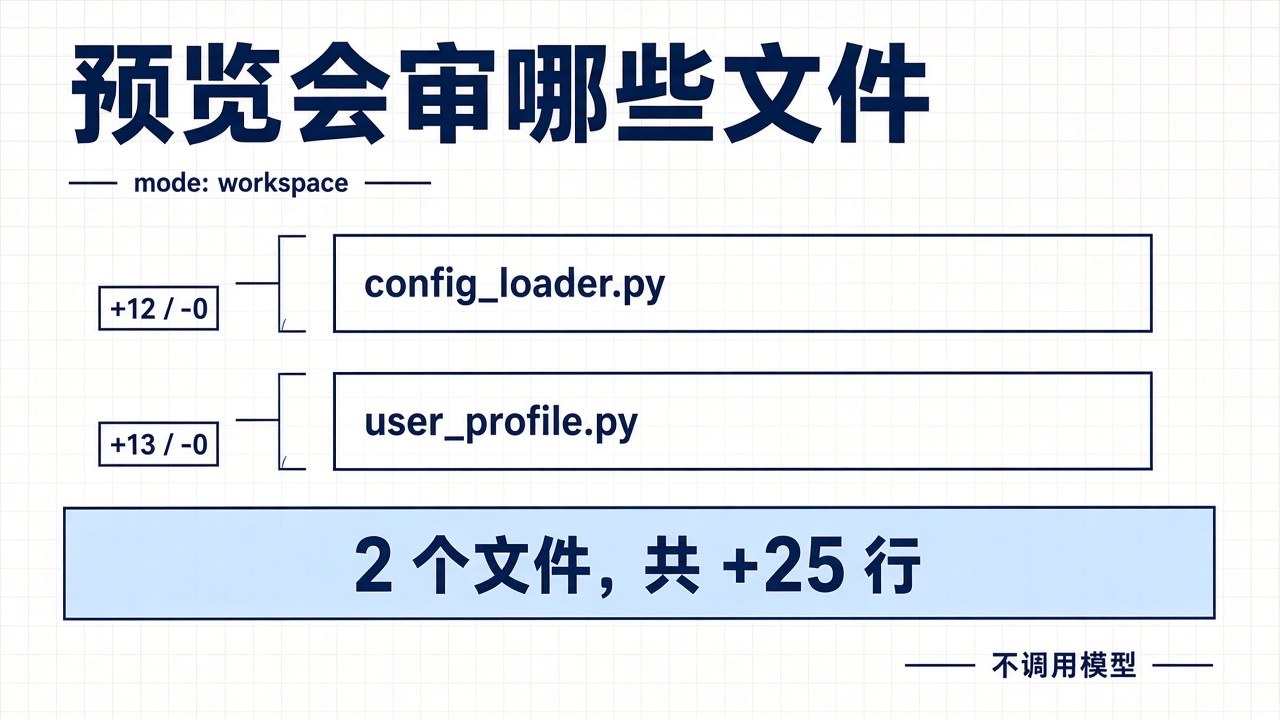
▲ 示意图:没配模型时,预览会审哪两份文件。蓝图示意,数字来自本机预览输出。
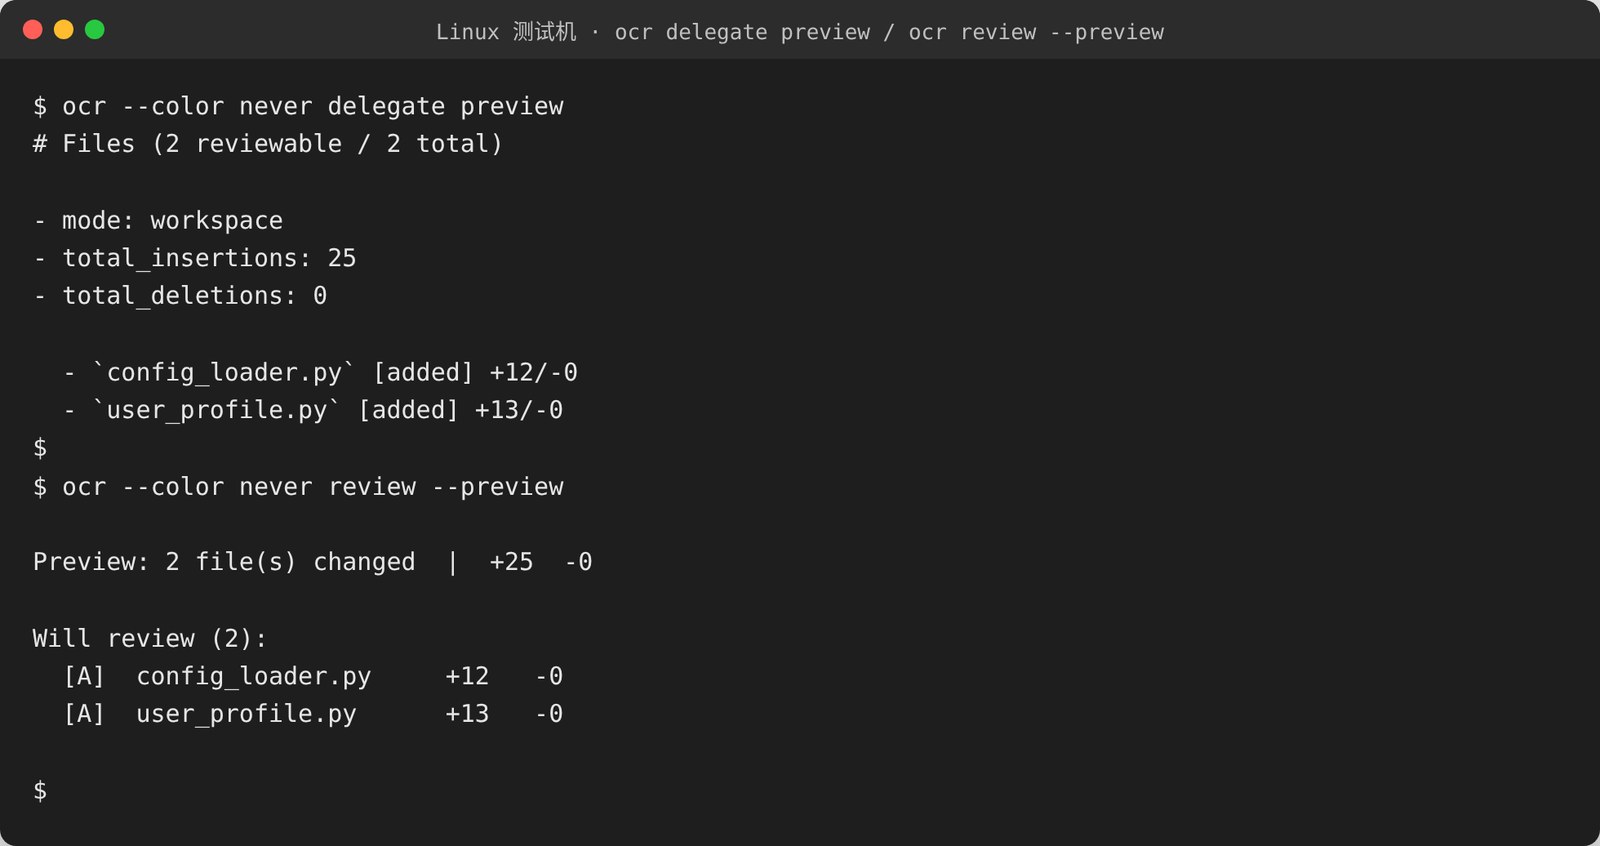
▲ 根据 Linux 测试机上两次预览命令的实际输出整理。北京时间 2026-11-14 15:03。演示仓库里暂存了 config_loader.py 和 user_profile.py。
然后我把这两个文件交给 ocr --color never delegate rule user_profile.py config_loader.py,退出码还是 0。它把两个文件分进同一组系统规则,分组标题是 system / **/*.{py,pyi,ipynb}。规则正文开头有一句总原则,大意是更看重准确,不要在没把握时乱报。再往下是若干检查类别,我在本机看到的标题包括:拼写错误、死代码、可变默认参数与共享状态、边界与空值、错误处理、相等比较、资源管理、性能、并发,以及一个名为 Security-Sensitive Code 的安全类。安全类只转述名称,这里不展开具体条目。
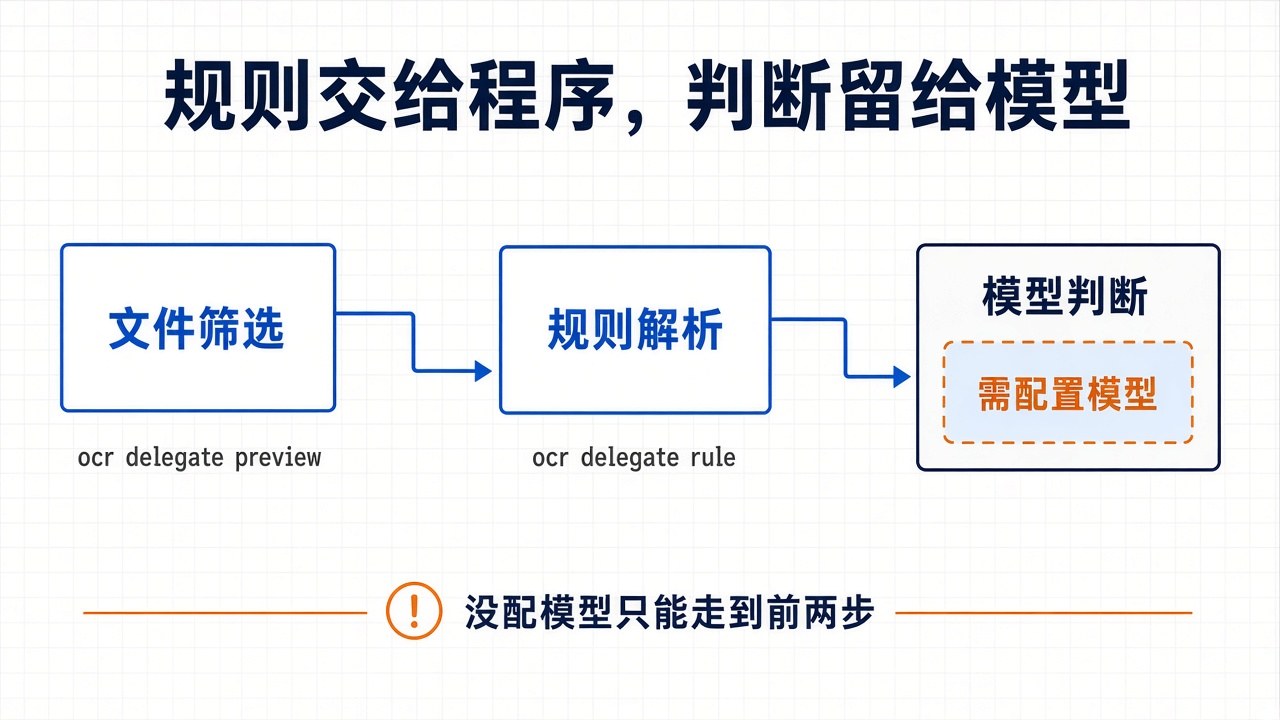
▲ 示意图:规则交给程序,判断留给模型。没配模型只能走到前两步。蓝图示意,不代表真实界面。
最后试了一次不配置模型的 ocr --color never review。它没有开始审查,直接报错,退出码是 1:
Error: resolve LLM endpoint: no valid LLM endpoint configured; one of OCR_LLM_URL/OCR_LLM_TOKEN/OCR_LLM_MODEL, ~/.opencodereview/config.json, or ANTHROPIC_BASE_URL/ANTHROPIC_AUTH_TOKEN/ANTHROPIC_MODEL must be set我又跑了 ocr --color never llm test,报错原文相同,退出码也是 1。跑完这些命令后,测试机上仍然没有出现 ~/.opencodereview/ 目录。
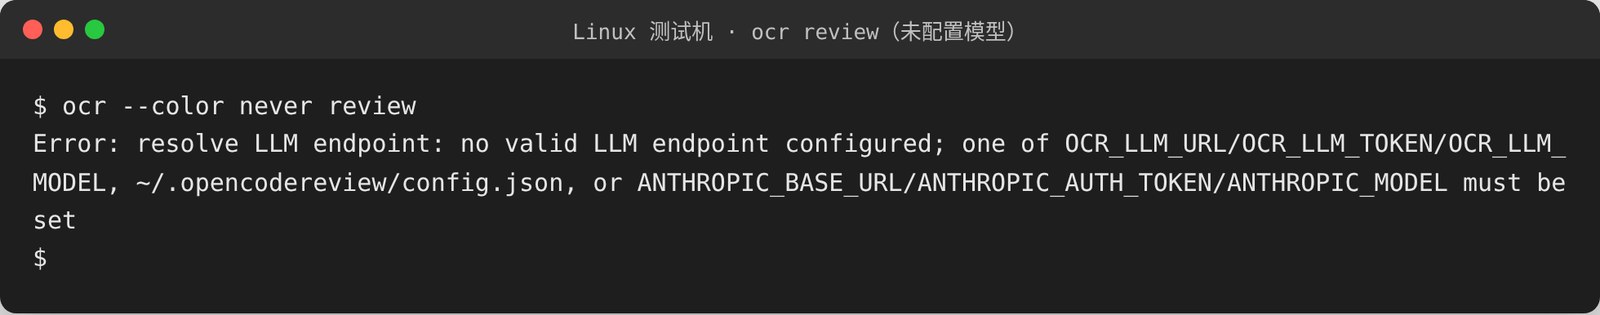
▲ 根据 Linux 测试机上 ocr review 的实际报错整理。北京时间 2026-11-14 15:03。退出码是 1。
如果要继续走完整审查,官方写的步骤仍是 ocr config provider,再 ocr config model,然后用 ocr llm test 检查连通性。配置会写到 ~/.opencodereview/config.json。我没有进入这些交互式命令,也没有向配置文件写入任何密钥。
· · ·
PART 06
官方基准怎么读
中文 README 里有一组项目方给出的对比,测试集叫 AACR-Bench,发布在 Hugging Face 的 Alibaba-Aone/aacr-bench。README 写的规模是:从 50 个热门开源仓库中选出 200 个真实 Pull Request,覆盖 10 种编程语言,由 80 多位资深工程师交叉标注,共 1,505 个标注缺陷。
在同一底层模型下,项目方称 Open Code Review 的准确率(Precision)和 F1 高于通用 Agent(文中用来对比的是 Claude Code),Token 消耗大约是对方的 1/9,审查更快;召回率(Recall)则更低。README 把这写成有意的取舍:宁可少报一些,也不要堆出一串假警报。
这组数字来自项目方的 AACR-Bench,不是我在测试机上做的对比,也不能理解成「装上就会比某个聊天模型更准」。我没有复测这套基准,也没有跑通带模型的审查,所以这里只转述口径,不补充本机成绩。
· · ·
PART 07
适合谁,先别急着配密钥
如果你已经在用编程 Agent,只是想先看这次改动会审哪些文件、会套哪组规则,委托模式和 --preview 现在就能用。我在未配置模型的情况下,这两步都跑通了。
如果你打算让 ocr 自己给出行级评论,还是要按官方步骤配置模型,并用 ocr llm test 确认连通,再运行 ocr review。没有可用模型、也不走委托模式的话,装完之后能确定走到的,就是预览和规则查询。
和编程助手、安全检查相关的站内文章,还可以看 Qwen Code 1.0 Preview 的安装核对,以及 Cloudflare 开源的 security-audit-skill。它们不是这篇的续篇,只是相近主题。






