

共计 2805 个字符,预计需要花费 8 分钟才能阅读完成。
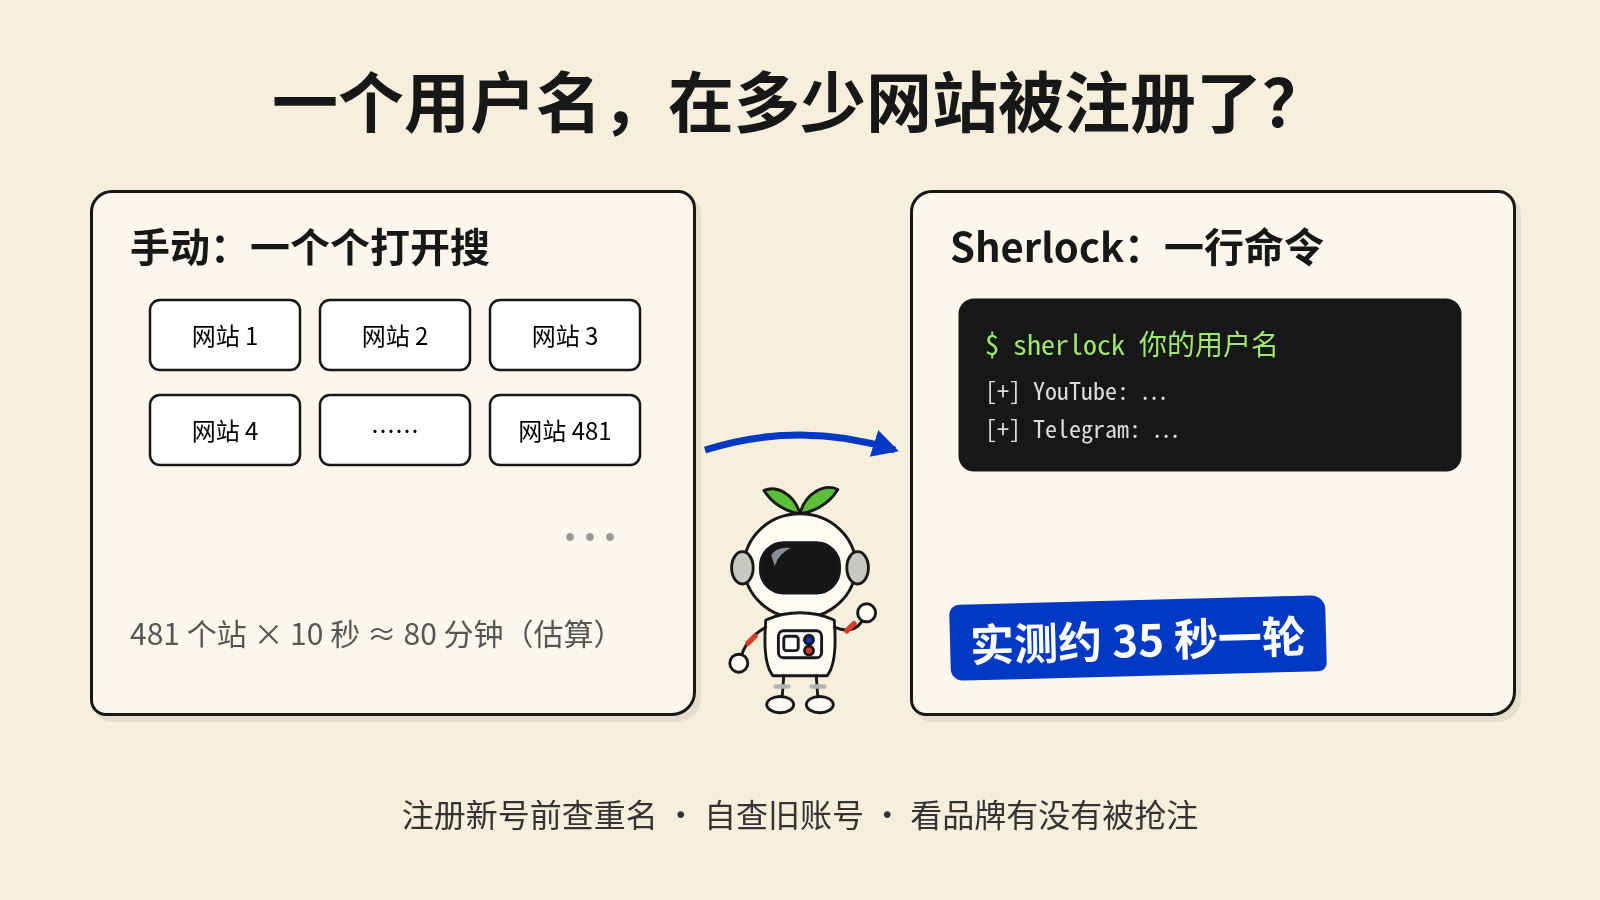
想给自己起个统一的网名,或者想知道自己常用的那个用户名在网上到底留了多少痕,老办法只有一个:打开网站,搜,关掉,再打开下一个。
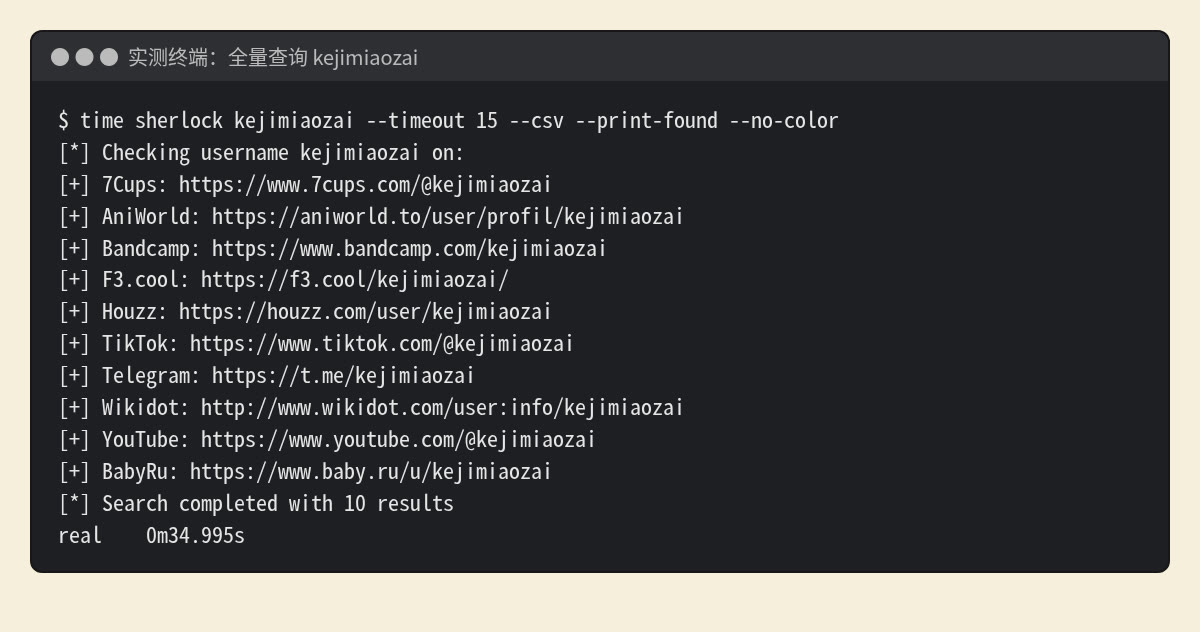
Sherlock 的办法是:在终端里敲一行 sherlock 你的用户名,它替你去 400 多个网站挨个敲门。我用自己的品牌名 kejimiaozai 跑了一遍,35 秒出结果。
这个项目最近两天在 GitHub 热榜上一天涨了 1800 多颗星,总星数已经过了 10 万。仓库 2018 年底就建了,算老项目,这回又被翻出来刷了一波。下面我把两种做法摆一起比,安装、用法、怎么看结果也一步步写出来。
它到底帮你省了什么
Sherlock 是个免费开源的命令行小工具(MIT 协议),只干一件事:告诉你某个用户名在哪些网站上已经有人注册了。 它不抓头像,不看资料,也不能证明这些账号是同一个人。
适合这几种情况:
- 准备在多个平台开号,想先找一个各家都还空着的名字
- 想看看自己多年前随手注册的旧账号还在不在,该注销的注销
- 有自己的品牌名,想知道有没有被别人抢注
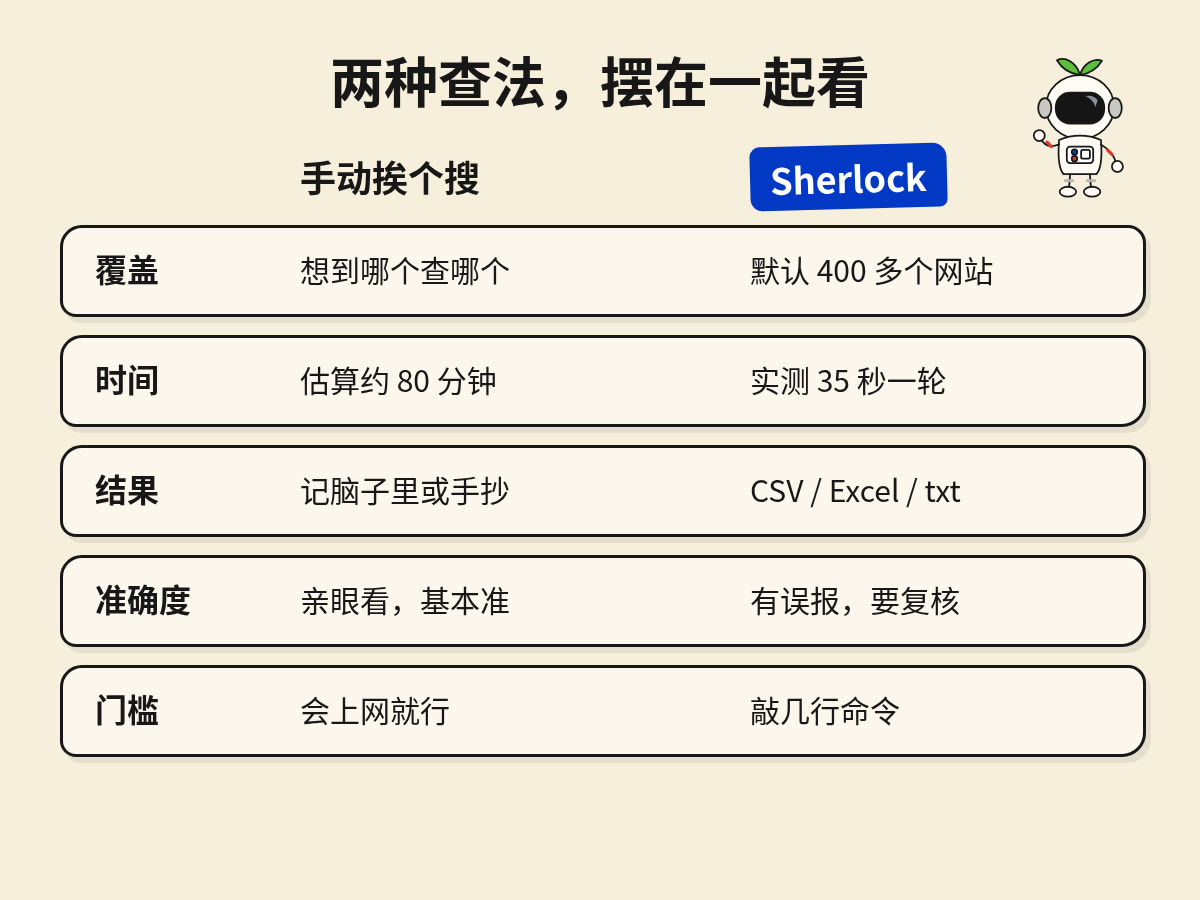
手动查的成本很好算。它的站点库里现在有 481 条记录,就算每个网站打开、搜、看结果只要 10 秒,全部过一遍也要 80 分钟左右,而且大概率搜到一半就不想干了。Sherlock 在我的 Linux 测试机上默认跑一轮花了 35 秒,结果还能直接存成表格。
安装:两条路选一条
需要电脑上有 Python 3(3.9 以上)。Linux 和 macOS 一般自带,Windows 去 python.org 装一个就行。我只在 Linux 上实测过,Windows 没跑。
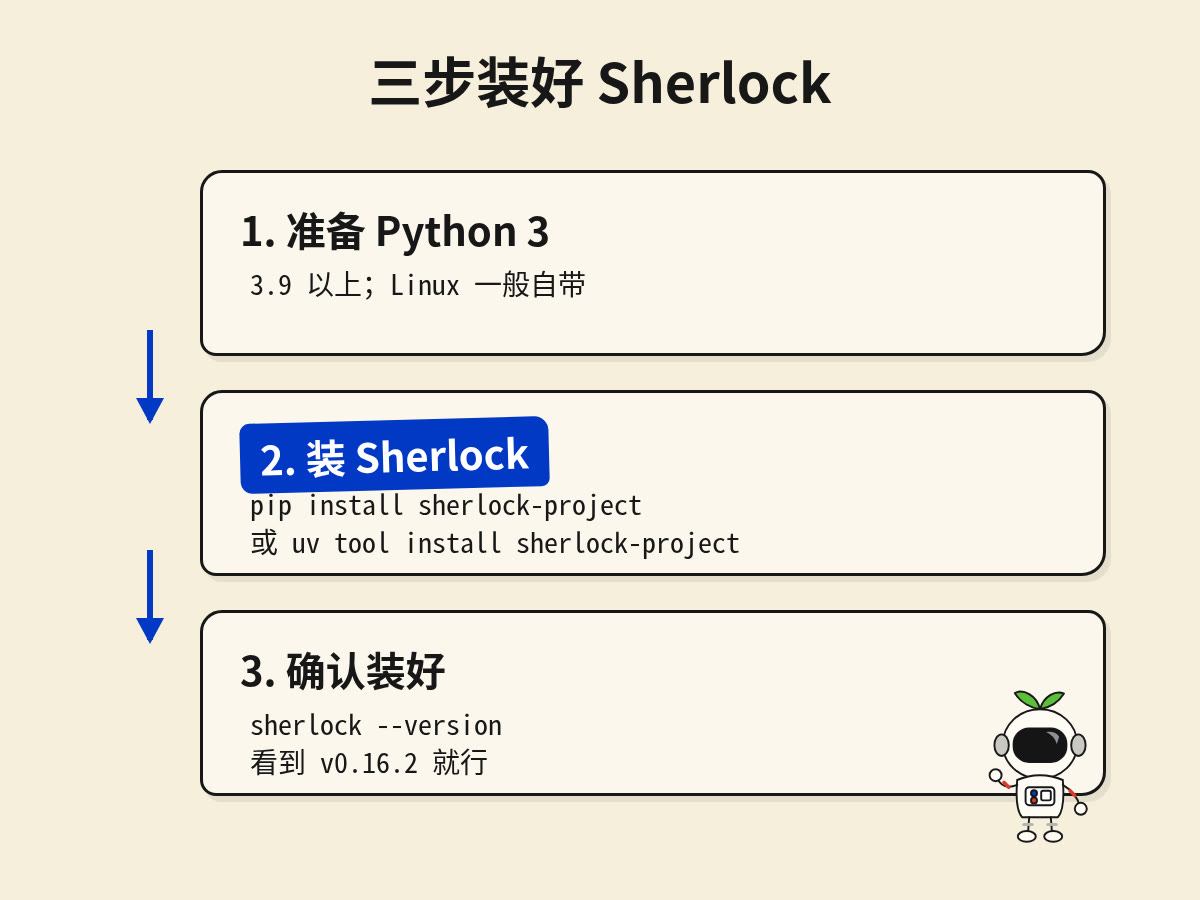
办法 A:虚拟环境(最稳)
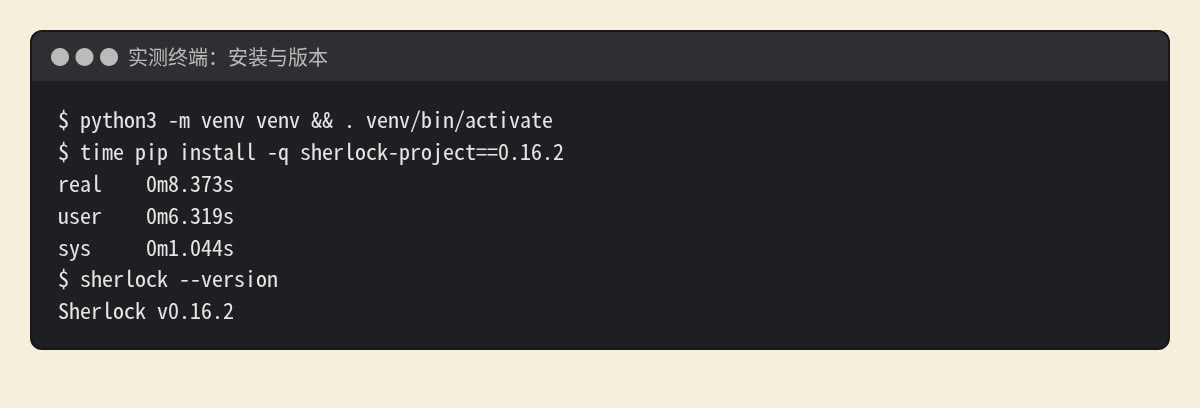
python3 -m venv sherlock-env
source sherlock-env/bin/activate
pip install sherlock-project
sherlock --version
最后一行出现 Sherlock v0.16.2 就是装好了。我这边 pip 装完用了 8 秒多。以后每次用之前先执行一次 source sherlock-env/bin/activate。
办法 B:用 uv(最快)
已经装了 uv 的话,一行搞定:
uv tool install sherlock-project
我实测 2.3 秒装完。如果它提示某个目录 “is not on your PATH”,照提示执行一次 uv tool update-shell,重开终端就能直接敲 sherlock 了。
官方安装页还提供 pipx 和 Docker 两种装法。有一点要注意:官方说 Ubuntu 24.04 和 ParrotOS 软件源里那个第三方打包是坏的,别用 apt install,走上面两条路。
用法:四条命令够用
1. 全网查一个名字
sherlock kejimiaozai --timeout 15 --print-found --csv
--timeout 15 是每个网站最多等 15 秒,默认要等 60 秒,碰上慢网站整轮会拖很久。--print-found 只显示找到的,--csv 把结果存成表格,用 Excel 或 WPS 都能打开,里面还带每个网站的响应码和耗时。
2. 只查几个常用平台
sherlock kejimiaozai --site YouTube --site Telegram --site GitHub --print-all
--site 可以重复写。只查 4 个平台时,我这边 5 秒就跑完了。日常只关心几个大平台的话,这个最省事。
3. 顺手查带符号的变体
sherlock "keji{?}miaozai" --site GitHub --site Telegram
{?} 会自动替换成下划线、横杠和点,一次查 keji_miaozai、keji-miaozai、keji.miaozai 三个名字。结果里看到 “Illegal Username Format” 不用慌,意思是这个网站不允许名字里带这个符号,本来就注册不了。
4. 想要文本或 Excel 文件
sherlock kejimiaozai --txt
sherlock kejimiaozai --xlsx
这里有个小坑:不少教程(包括官方 README)都说查完会自动存一个 用户名.txt,我用 0.16.2 实测,不加 --txt 一个 txt 都没生成。想要文件就把参数写上。
看结果:别把「找到」全当真
这一步最多人踩坑。我第一次查 kejimiaozai,终端里列了 10 个「找到」,有 7Cups、Houzz、俄罗斯育儿网站 BabyRu……我从来没注册过这些。
于是我编了一个肯定没人用的乱码名 zq8xk2vmw7tr 再查一遍,结果也「找到」了 9 个,其中 8 个和刚才一模一样。
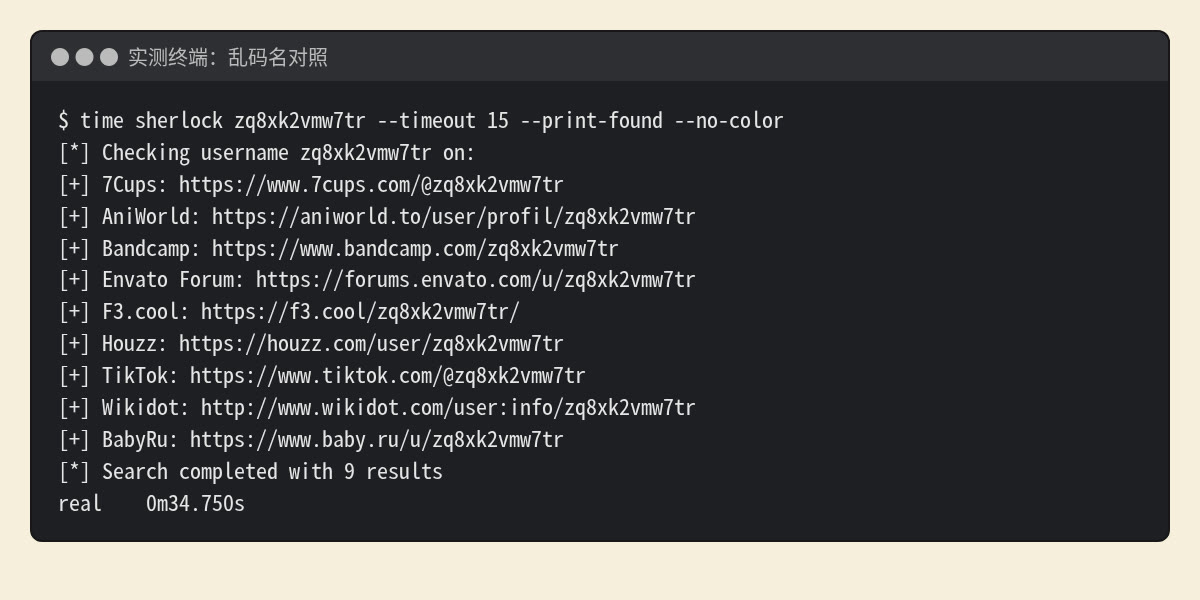
这说明这 8 个网站在我的网络环境下不管查谁都报「有」,属于误报。原因多半是这些网站对机房 IP 弹了验证页,或者改了页面,Sherlock 的判断规则还没跟上。两边去掉重复的,只剩 YouTube 和 Telegram 两条。我把这两个页面拉下来核对,YouTube 那个页面标题就是「科技喵仔 – YouTube」,确实是自家频道。
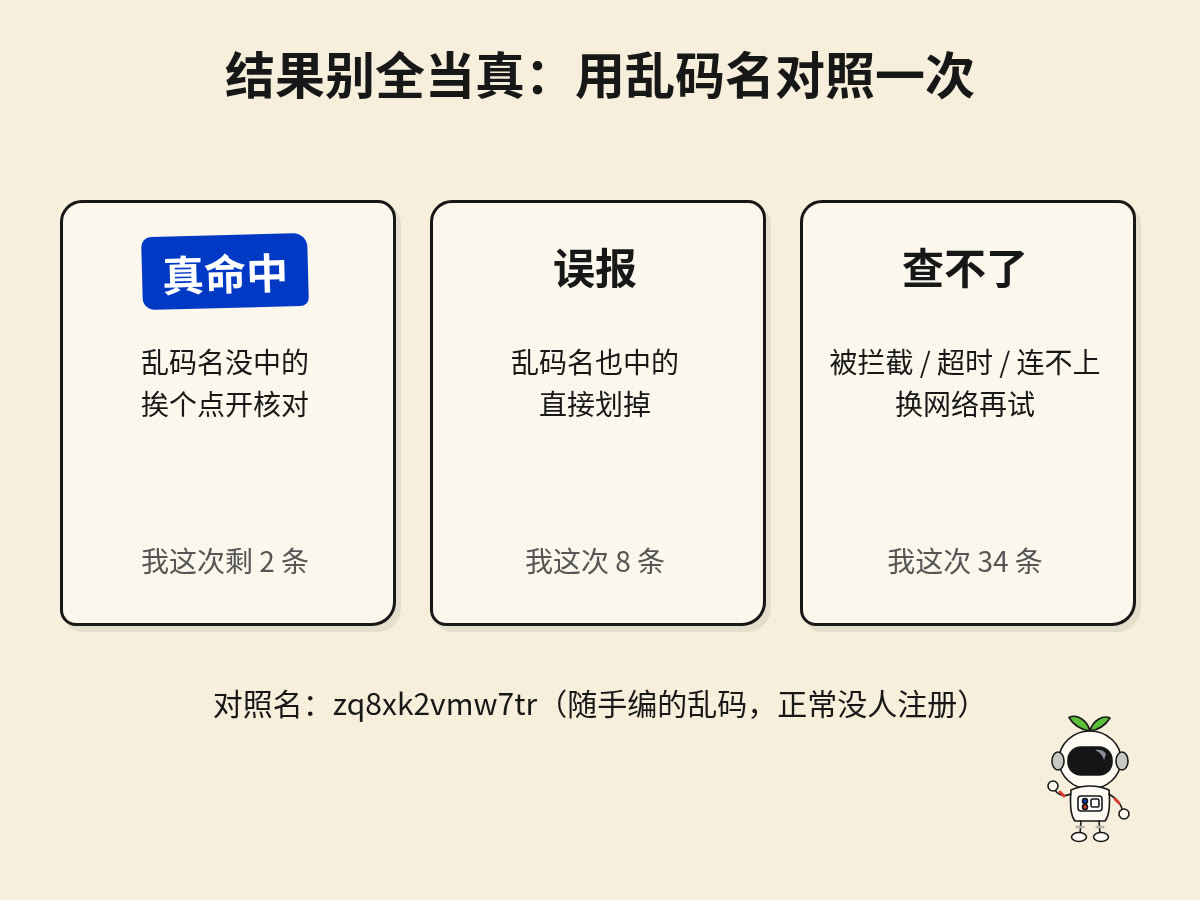
所以我的建议是,结果分三类看:
- 真命中:用乱码名对照一次,乱码名也中的全部划掉,剩下的挨个点开看
- 误报:乱码名也中的;以后同一台电脑、同一个网络,这几个都可以直接忽略
- 查不了:结果里写 “Blocked by bot detection”、”Timeout”、”Error Connecting” 的。我这一轮被拦了 23 个、超时 4 个、连不上 7 个。不代表没注册,只是这次没查成,换个网络再试,或者手动去搜
还有一种情况:单独用 --site Reddit 查时,它报 Reddit 有这个号,可我去访问那个链接,Reddit 直接返回拦截页,什么也看不到。这种算存疑,别急着下结论。
用之前想清楚边界
Sherlock 查的都是公开页面。拿来查自己、查自家品牌、给新账号挑名字都没问题;拿去盯别人就别了,不少地方的法律对跟踪骚扰也有规定。
另外它只看「这个名字有没有人用」,同名不代表同一个人。查到某网站有 kejimiaozai,也可能是别人先起了这个名字。
两种做法放一起
| 手动挨个搜 | Sherlock | |
|---|---|---|
| 覆盖 | 想到哪个查哪个 | 默认 400 多个网站 |
| 时间 | 按每站 10 秒估,全量约 80 分钟 | 我实测 35 秒一轮 |
| 结果 | 记在脑子里或手抄 | CSV / Excel / txt |
| 准确度 | 亲眼看,基本准 | 会有误报,要用乱码名对照 |
| 门槛 | 会上网就行 | 要敲几行命令 |
我现在的用法是让 Sherlock 先把 400 多个站筛一遍,剩下两三条可疑的再手动点开看。比纯手动省掉一大截,又不至于被误报带偏。
同样是 Python 写的命令行工具,想自动抓网页内容可以看看我之前写的 Scrapling 安装和使用教程。
如果觉得自己操作比较麻烦,也可以联系科技喵仔获取成品。






