

共计 3465 个字符,预计需要花费 9 分钟才能阅读完成。
X 上最近几天反复刷到 Hex。OpenCode 团队那条介绍帖浏览量过百万:按住快捷键说话,松手,字贴进当前窗口;模型下完后不出网。仓库在 anomalyco/hex,许可证 MIT。我今天下午在 Linux 测试机上装的是 3.3.0(发布于北京时间 2026-11-03 00:43 前后的 GitHub release)。
我这台机器没有真实麦克风。完整的「按住说话」链路我没跑通,listener 一直是 Couldn't enable。这台机器上我验收了安装、模型列表、SenseVoice Small 下载,以及 hex model transcribe 吃 WAV。下面按验收项写,数字都来自本机。
本次环境:Debian 测试机 · x86_64 · Hex 3.3.0(官方 linux-x64.deb,包内二进制约 70 MB)· 模型 SenseVoice Small(安装后文件 241 MB)· 2026-11-03 下午(Asia/Shanghai)
装哪个包
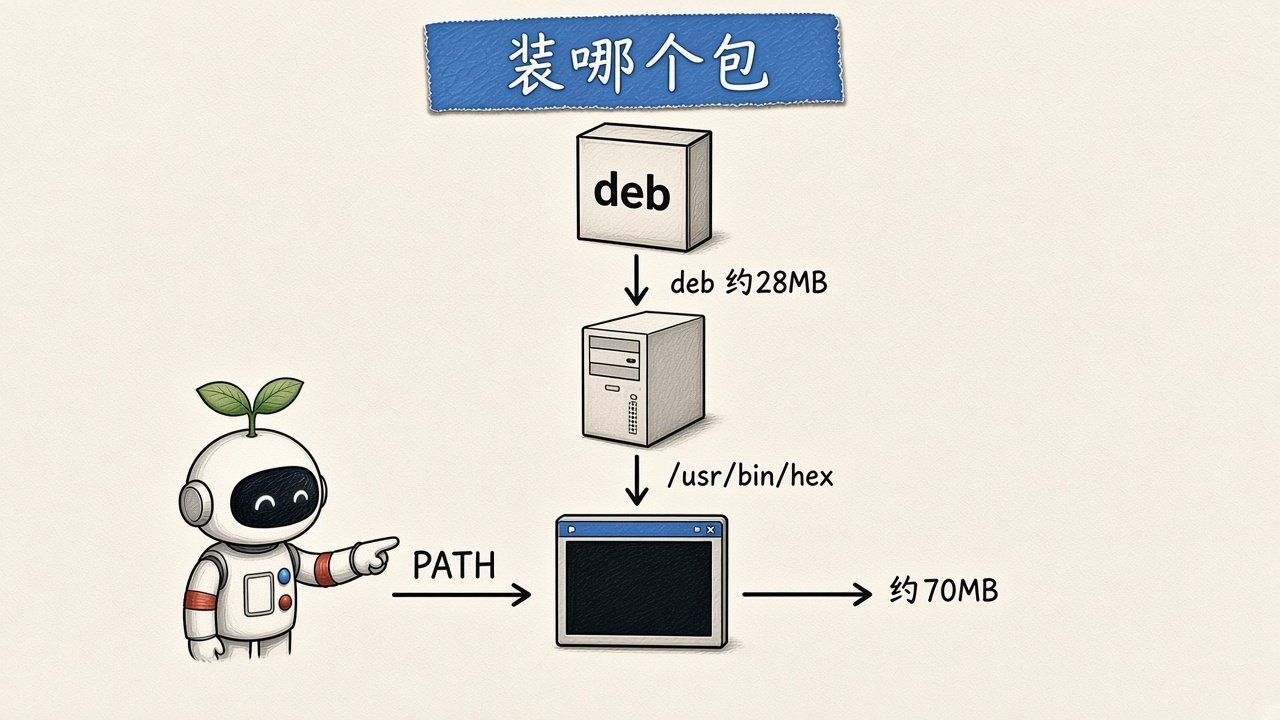
官网 anoma.ly/hex 给了 Linux 的 deb / rpm / 裸二进制,还有一行 curl … | sh。我下的是:
hex-3.3.0-linux-x64.deb  ·  约 28 MB
sha256  e5b3678eed33ca07c8771508f58df86a346f6b71324366ee93d205e8a6d54450
解出来主程序在 /usr/bin/hex,约 70 MB。不装进系统也能跑:把 usr/bin 加进 PATH 就行。依赖里写了 ALSA、Vulkan、X11/Wayland 相关库;推荐项有 wl-clipboard、wtype。
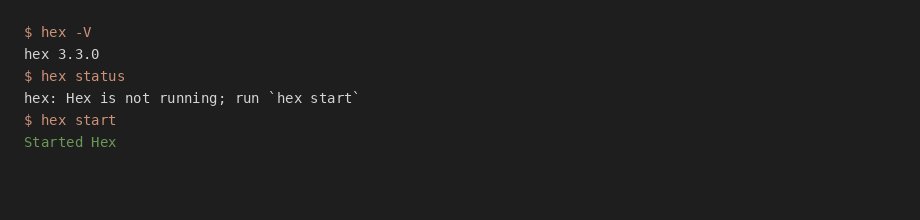
hex -V
# hex 3.3.0
hex start
# Started Hex
hex status
# … model: SenseVoice 未装时会显示 Model required
hex 不只是 GUI。Linux 上 CLI 能管状态、模型、设置、历史,也能对 WAV 做转写——这点救了我这台没麦的机器。
模型表我怎么选
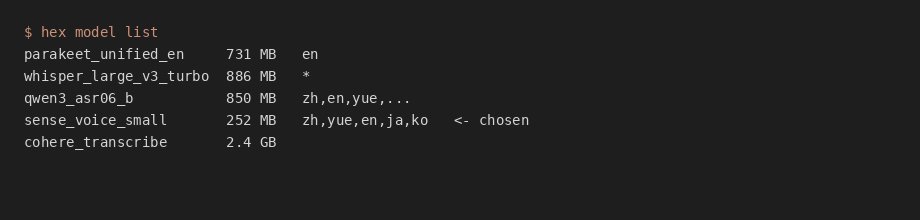
hex model list 列出可下载的转写模型。我抓到的时候大致是这样(体积以官方列表为准):
| id | 体积 | 语言要点 |
|---|---|---|
| sense_voice_small | 252 MB | zh / yue / en / ja / ko |
| parakeet_unified_en | 731 MB | en,支持流式 |
| qwen3_asr06_b | 850 MB | 含 zh、en、yue 等 |
| whisper_large_v3_turbo | 886 MB | * 多语 |
| cohere_transcribe | 2.4 GB | 多语,体积最大一档 |
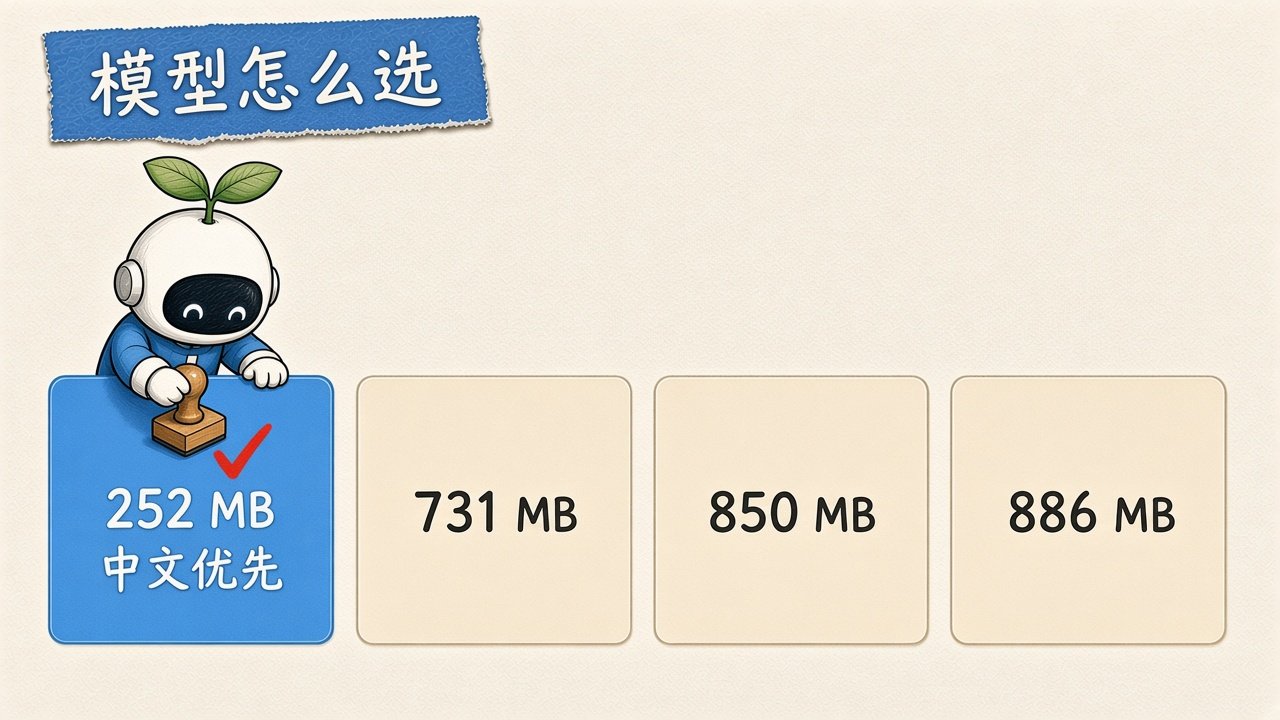
我要中文,又想先把流程跑通,就选了体积最小的 SenseVoice Small。英文流式听写以后可以再试 Parakeet;要更好的中文识别,队列里还有 Qwen3-ASR 0.6B,只是多下大约 600 MB。
SenseVoice 下载验收
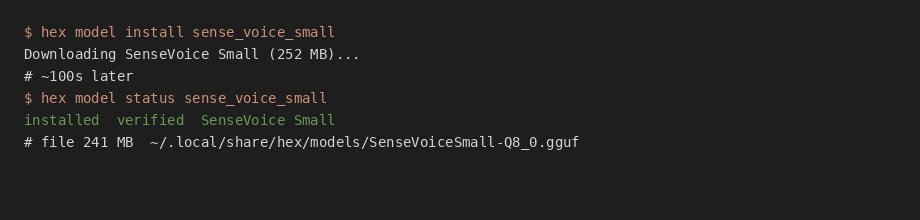
hex model install sense_voice_small
# Downloading SenseVoice Small (252 MB); …
本机从开始下到 installed verified,墙钟大约 100 秒。落盘文件:
~/.local/share/hex/models/SenseVoiceSmall-Q8_0.gguf  ·  241 MB
sha256  6c759ee4c9748c9b3f7a5a60ca74f0f7e685fb9d45d1378fce7cfd62f59adf29
另外还自动来了一个 VAD 小文件 silero-vad-v6.2-F32.gguf(约 1.2 MB)。hex model status sense_voice_small 返回 installed verified。hex model check sense_voice_small 在我这台 Intel Xeon 上显示 ready(计算设备是 cpu,状态行里带了约 16 GB 内存信息)。
三段 WAV,本机转写数字
没麦就造音频。中文那段我用 Edge TTS 合成了一句「你好,我在用 Hex 做本地听写测试。今天是十一月三日。」——这是合成音,不是真人麦克风,只用来验收转写通路。英文两段:Whisper 测试集里的 JFK 演讲片段,以及 Wikimedia 上的 Example 音效说明。
命令形态:
hex model transcribe zh-hex-test.wav --model sense_voice_small --language zh
hex model transcribe jfk.wav --model sense_voice_small --language en
结果(墙钟用本机毫秒计时):
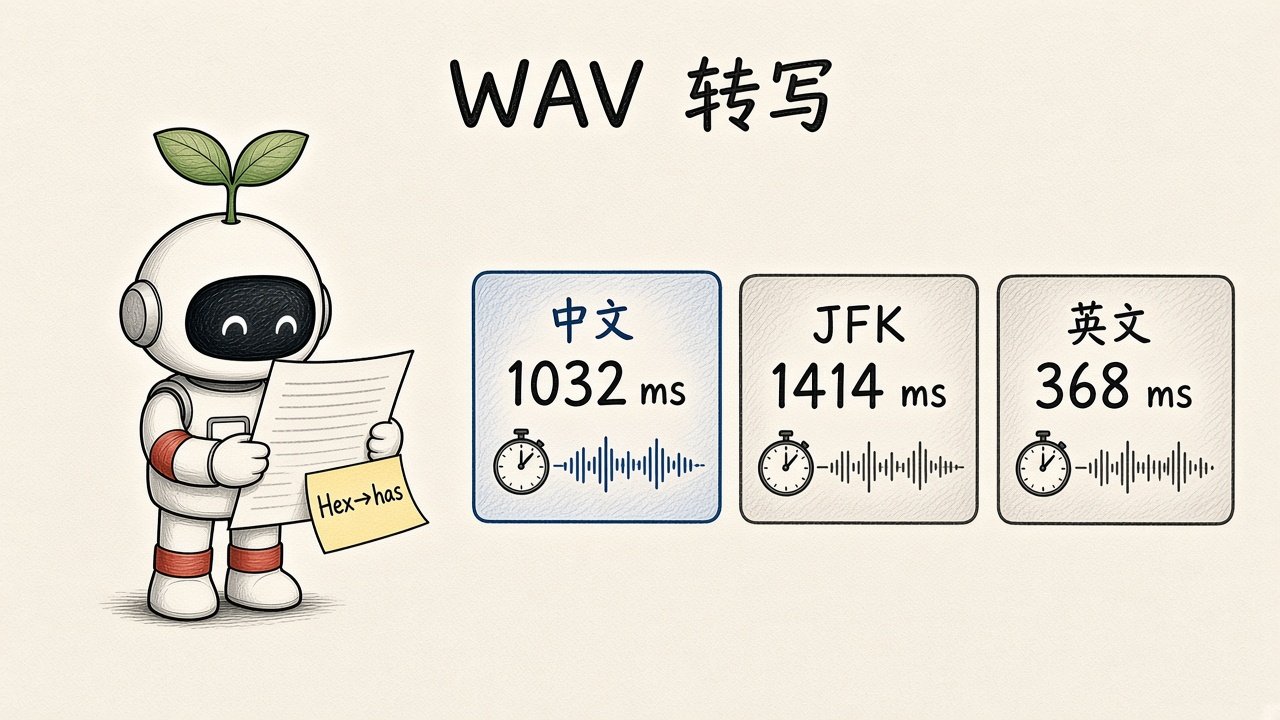
| 文件 | 时长 | 墙钟 | 输出摘要 |
|---|---|---|---|
| zh-hex-test.wav | ≈6.0 s | 1032 ms | 你好,我在用has做本地听写测试。今天是11月3日。 |
| jfk.wav | ≈11.0 s | 1414 ms | 经典 JFK 名句,英文完整 |
| en-example.wav | ≈6.1 s | 368 ms | 识别成 Example 音效的英文说明 |
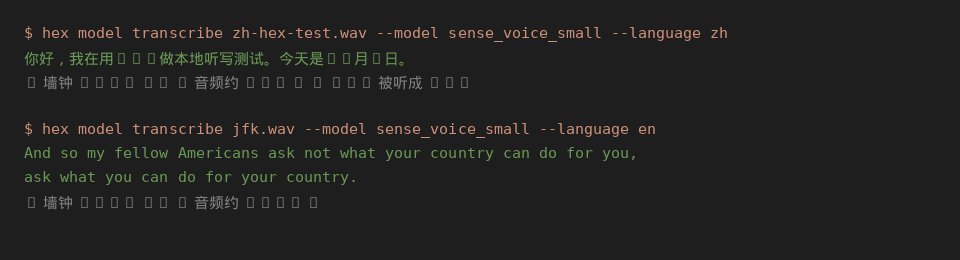
中文那句里,Hex 被听成了 has。日期「十一月三日」收成了「11月3日」,能接受。专有名词翻车正是词汇表功能存在的理由——CLI 有 hex vocabulary,我还没往里面加词,下次会把 Hex 加进去再测一遍。
JFK 那段听得很稳。说明:同一模型、CPU 推理,十秒级英文音频大约一秒出字;中文六秒音频也在一秒出头。这是 文件转写,不是按住快捷键时的流式听写延迟。
真麦这关:listener 起不来
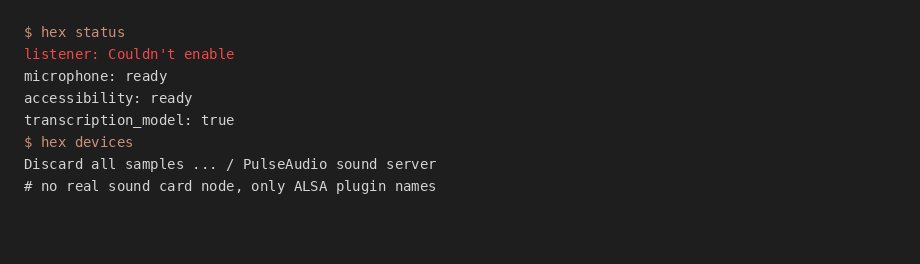
装好模型后 permissions.transcription_model 已是 true,microphone / accessibility 显示 ready,但:
listener: Couldn't enable
hex devices 列出来的是 ALSA 插件名(PulseAudio、JACK、丢弃采样那种),没有真实声卡节点。所以我不能诚实地说「按住说话松手出字」在这台机器上可用——那句广告语在有麦的桌面 Linux 上才成立。我能担保的是:模型下载、校验、WAV 转写这条 CLI 路径是通的。
进程在转写前后 RSS 大约 80 MB 量级(hex app --hidden);模型文件本身 241 MB 在磁盘上,不等于常驻内存。更细的内存峰值我没采。
我没测到的
- 有真实麦克风时的按键听写延迟、误触、以及和剪贴板粘贴的配合
- Parakeet 流式英文、Qwen3-ASR 中文对比
hex vocabulary加词之后,「Hex」还会不会变成 has- Wayland / X11 下
wtype/ 剪贴板的实际粘贴行为 - Windows / macOS(官网写明支持,我没装)
- Meetings、Annotate、MCP 那些 Labs 功能
下一步我自己会做两件事:有麦的桌面机上重跑一遍按键听写;以及用 hex vocabulary 把 Hex 加进词表,看还会不会变成 has。装的顺序我会继续用:先 hex model list 选体量,再 install,再用一段自己的 WAV 看专有名词。
出处
- 仓库与 release:https://github.com/anomalyco/hex / https://github.com/anomalyco/hex/releases/tag/v3.3.0
- 官网:https://anoma.ly/hex/
- X 热议入口(OpenCode):https://x.com/opencode/status/2116555630236577819
- X News 综述页:https://x.com/i/trending/2116678391482953816
- 本机文件:SenseVoiceSmall-Q8_0.gguf 241 MB;zh/jfk/en 三段 WAV 时长与墙钟见上文






