共计 5727 个字符,预计需要花费 15 分钟才能阅读完成。
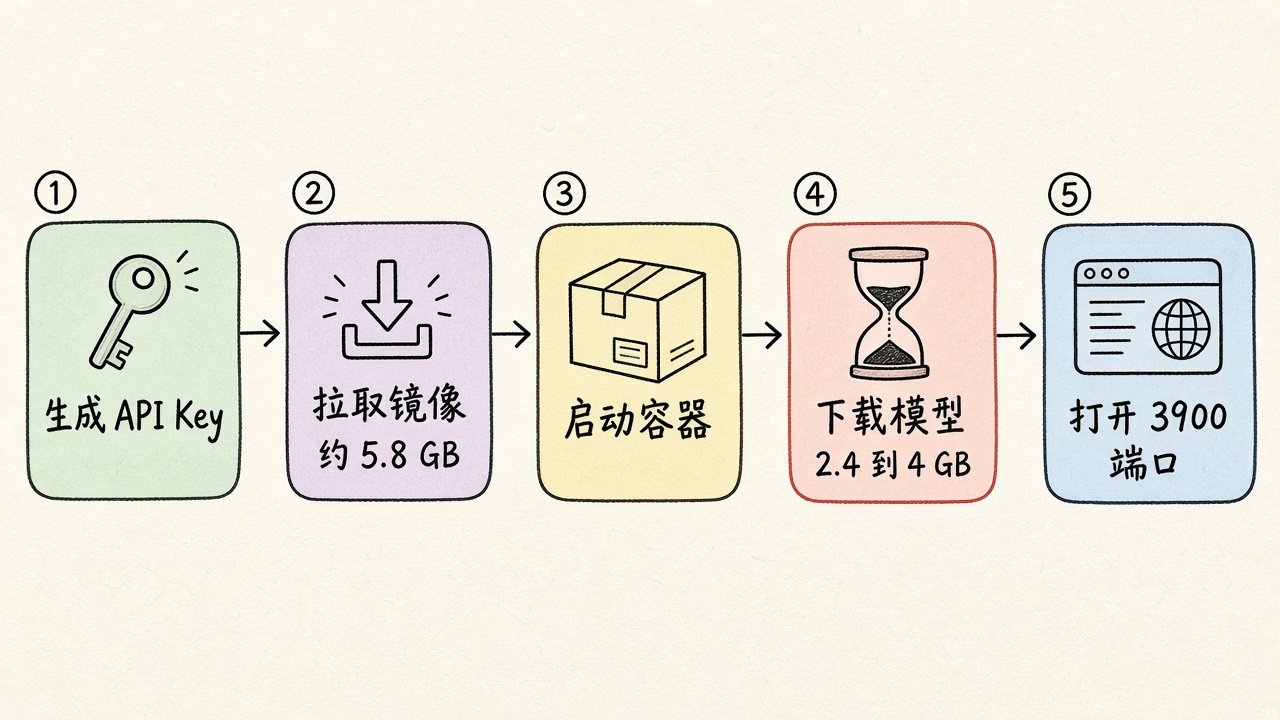
先给最短路径。一台 x86 的 Linux 机器,装好 Docker,下面三条命令跑完,在本机浏览器打开 http://localhost:3900 就能用:
export OMNIVOICE_API_KEY="$(python3 -c 'import secrets; print(secrets.token_urlsafe(32))')"
docker pull ghcr.io/debpalash/voicestudio:stable
docker run -d --name omnivoice \
  -p 127.0.0.1:3900:3900 \
  -e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" \
  -v omnivoice-data:/app/omnivoice_data \
  ghcr.io/debpalash/voicestudio:stable
命令全部来自项目的 Docker 安装文档(docs/install/docker.md)。我这次没有在自己的服务器上把镜像拉下来跑一遍,下面凡是要看你机器情况的地方,我会写清楚是文档怎么说的。
1. VoiceStudio 是干什么的?
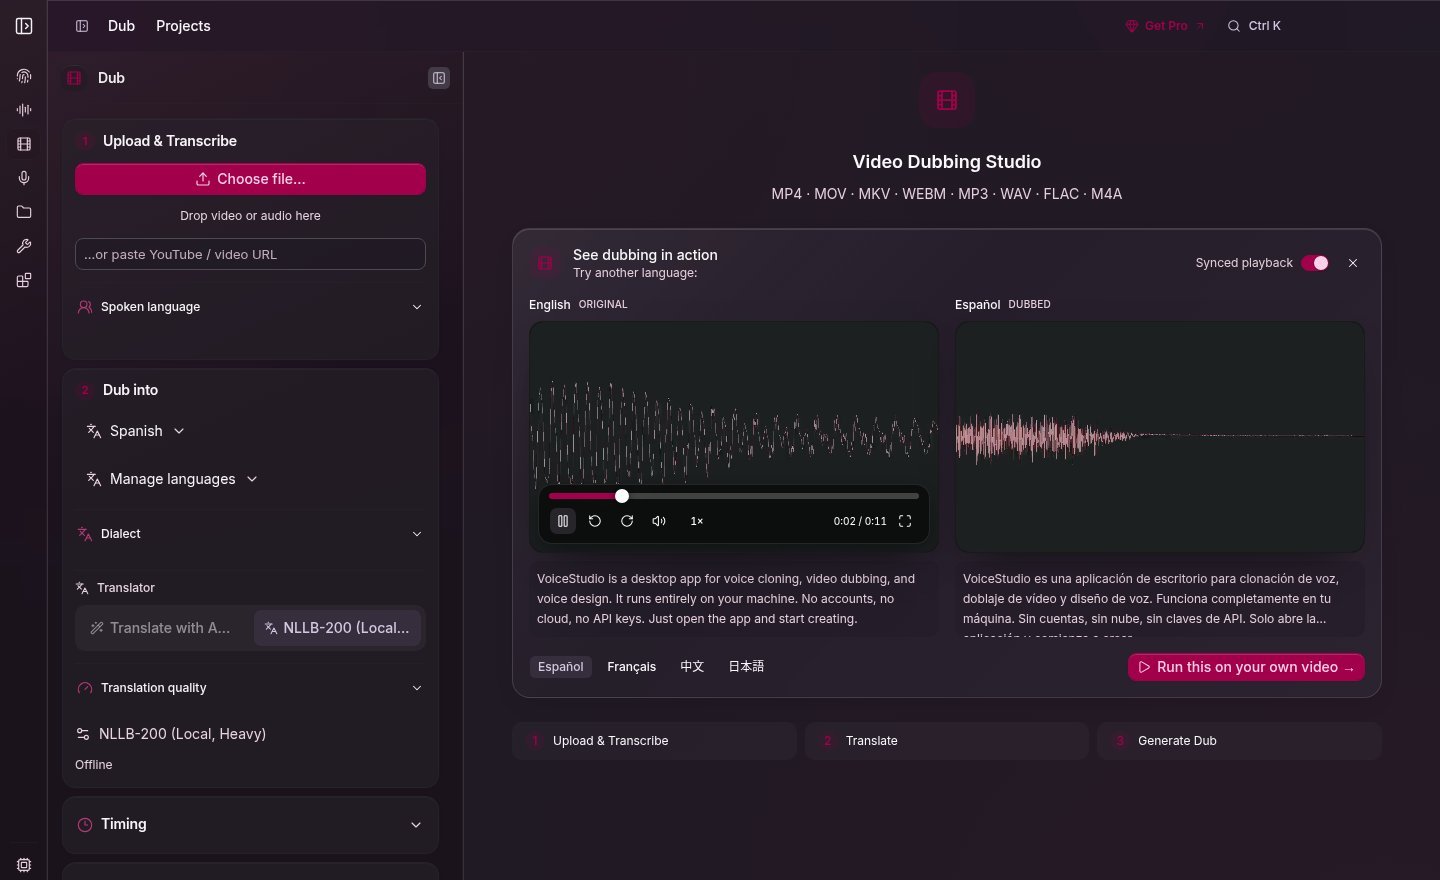
一句话:在你自己的机器上做声音克隆、按描述设计新声音、给视频配音、听写转录和做有声书。README 写的是支持 646 种语言,默认引擎叫 VoiceStudio,底层用的是 k2-fsa 的 OmniVoice,也可以换别的引擎。
它有桌面版(macOS、Windows、Linux),有手机预览版,也有 Docker 镜像。Docker 版把后端和网页界面打包在一起,你用浏览器访问,适合放在没有桌面环境的服务器上。
数字先放这里:截至 10 月 27 日下午,GitHub 上约 9 万个 star(89,959),约 9,900 个 fork,许可证 AGPL-3.0。v0.5.7 在北京时间 10 月 26 日 22:59 发布,10 月 27 日下午它在 GitHub Trending 日榜上显示当天新增 2,297 个 star。
2. 我的 VPS 没有显卡,能跑吗?
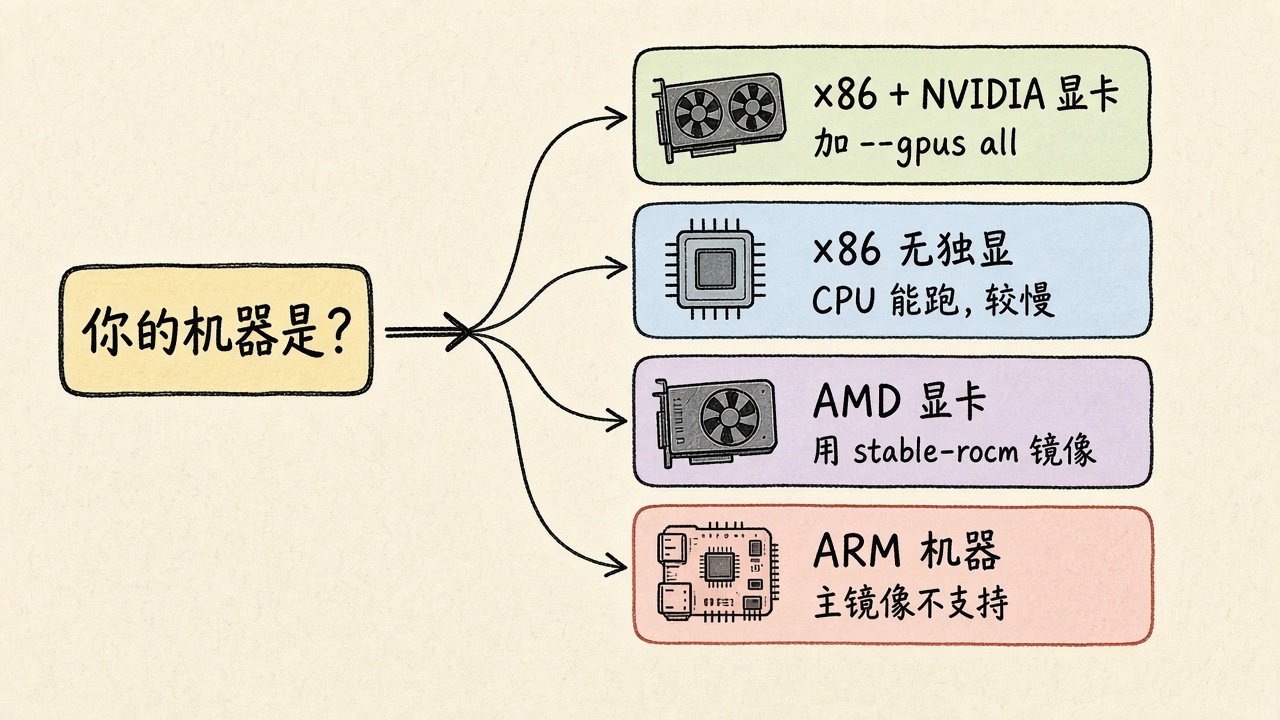
能跑,就是慢。README 的硬件表里写得很直白:没有独立显卡的机器可以完整使用,速度会慢一些,CPU 版 PyTorch 大约需要 5 GB 空闲磁盘。
有 NVIDIA 显卡的机器,在 docker run 里加一个 --gpus all:
docker run -d --name omnivoice --gpus all \
  -p 127.0.0.1:3900:3900 \
  -e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" \
  -v omnivoice-data:/app/omnivoice_data \
  ghcr.io/debpalash/voicestudio:stable
前提是宿主机装好了 NVIDIA Container Toolkit,不然 --gpus 这个参数会直接报错。
AMD 显卡要换成 :stable-rocm 镜像,把显卡设备直接映射进去:
docker run -d --name omnivoice \
  --device /dev/kfd --device /dev/dri \
  -p 127.0.0.1:3900:3900 \
  -e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" \
  -v omnivoice-data:/app/omnivoice_data \
  ghcr.io/debpalash/voicestudio:stable-rocm
内存要多少,文档没有给一个统一的数。它的说法是不同引擎需求不同,看 docs/performance.md。我自己的判断是 1 GB、2 GB 内存的小鸡不用试了,模型文件本身就有几个 GB。这一点我没有实测,只是按模型体积推的。
3. 我是 ARM 机器,能用 Docker 吗?
大多数情况不行。主镜像(:stable、:latest 这些)只有 linux/amd64。在 ARM 机器上直接拉,文档说会看到这个错误:
no matching manifest for linux/arm64/v8 in the manifest list entries
分三种情况:
- ARM 服务器带 NVIDIA 显卡(文档点名 DGX Spark / GB10、GH200、GB200):用专门的
:stable-cuda-arm64镜像。 - Apple Silicon 的 Mac:别用 Docker,装原生 macOS App,能用上 Metal 加速。容器里调不到 Mac 的 GPU。
- 其他 ARM 机器:可以在 pull 和 run 的镜像名前面加
--platform linux/amd64走模拟,文档原话是 inference can be much slower,而且只对 CPU 有意义。
还有一个容易忽略的:Intel 芯片的 Mac 只能跑界面,要连一台远程后端。
4. OMNIVOICE_API_KEY 是干嘛的?能不设吗?
不能省。文档解释了原因:Docker 的网络地址转换让后端没法确认浏览器是不是在本机,所以设置页和诊断这些管理操作必须带一个管理员 Key,哪怕端口只绑在 127.0.0.1 上也一样。
用 compose 启动时,配置文件里写的是 ${OMNIVOICE_API_KEY:?...},没设这个变量,compose 会直接拒绝启动,并提示你先 export 一个长随机 Key。
网页第一次打开会让你输入这个 Key,它换成一个短期会话,不会把主 Key 存在浏览器里。所以生成 Key 的那个终端先别关,或者把 Key 记到密码管理器里。
5. 用 docker run 还是 docker compose?
只是想试试,开头那条 docker run 已经够了。打算长期放在服务器上,再换成文档标注推荐的 compose。它要先把仓库克隆下来,因为 compose 文件在 deploy/ 目录里:
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
export OMNIVOICE_API_KEY="$(python3 -c 'import secrets; print(secrets.token_urlsafe(32))')"
# 三选一
docker compose -f deploy/docker-compose.yml --profile cpu up -d
docker compose -f deploy/docker-compose.yml --profile gpu up -d
docker compose -f deploy/docker-compose.yml --profile rocm up -d
compose 起来的容器名和 docker run 不一样:CPU 版叫 omnivoice-studio,NVIDIA 版叫 omnivoice-studio-gpu,ROCm 版叫 omnivoice-studio-rocm。后面看日志、进容器时别敲错。
我更偏向长期用 compose,它自带健康检查,更新也只要两条命令(第 10 问)。
6. 第一次启动为什么半天打不开?
先是镜像本身大。我用 GitHub 容器仓库的接口查了 :0.5.7 的 amd64 镜像,20 层压缩后加起来 5,808,023,806 字节,约 5.8 GB,这还没算模型。小硬盘的 VPS 先 df -h 看一眼。
镜像拉完、容器起来以后,它还要下模型。docker.md 写的是首次运行下载约 2.4 GB 模型权重,compose 文件开头的注释写的是约 4 GB。两处数字不一样,按 4 GB 准备磁盘和时间比较稳。
看下载进度:
docker logs -f omnivoice           # docker run 启动的
docker logs -f omnivoice-studio    # compose CPU 版
compose 文件里的健康检查跑的是 curl -sf http://localhost:3900/health,等它通过再打开页面。
模型从 Hugging Face 下载。VoiceStudio 会自动在 huggingface.co 和镜像站 hf-mirror.com 之间测速选一个快的,人在海外一般会走官方站。想固定某一个,设环境变量 HF_ENDPOINT。
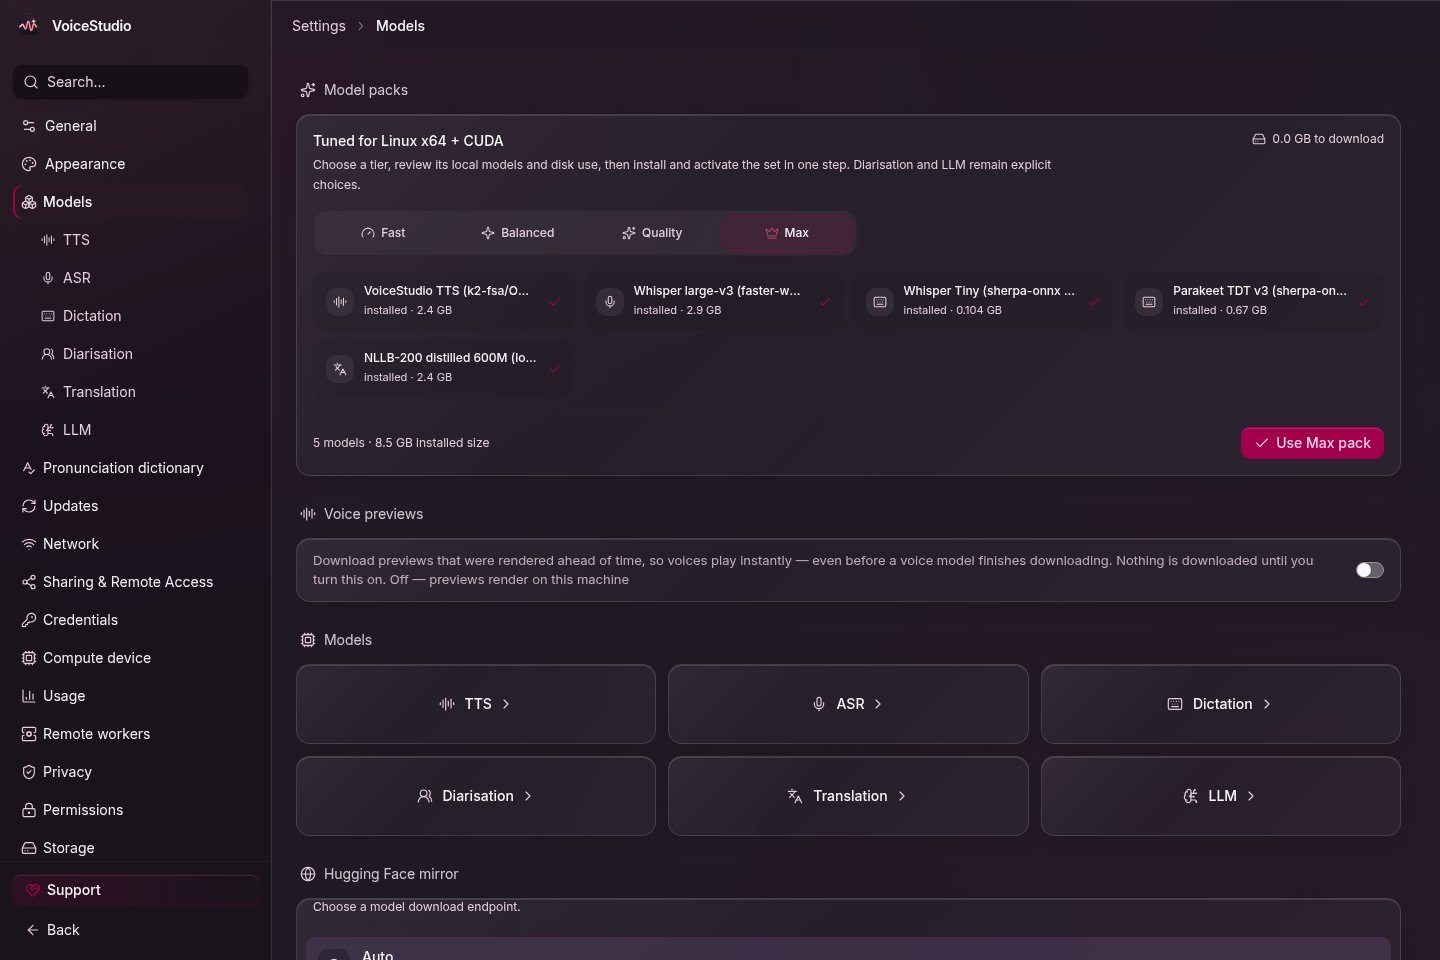
后面如果在设置里装「Max」模型包,体积会大很多。README 的截图里,Max 包 5 个模型一共 8.5 GB,其中 VoiceStudio TTS 2.4 GB,Whisper large-v3 2.9 GB。
7. 镜像标签选 :stable 还是 :latest?
选 :stable。
很多项目的 :latest 就是最新正式版,这个项目不是。它的 :latest 和 :main 是 main 分支每次提交滚动构建的预览版,发正式版不会动它。:stable 才跟着 GitHub Release 走。
想再稳一点,可以钉死到具体版本号,比如 :0.5.7(我查过这个标签已经发布)。这样哪天上游推了有问题的新版,你的服务不会跟着变。代价是要自己记得手动升级。
8. 想在手机或另一台电脑上用,怎么安全地连过去?
默认配置只让本机访问,这是故意的。端口映射写的是 127.0.0.1:3900:3900,左边那个 127.0.0.1 决定了只有服务器自己能连。
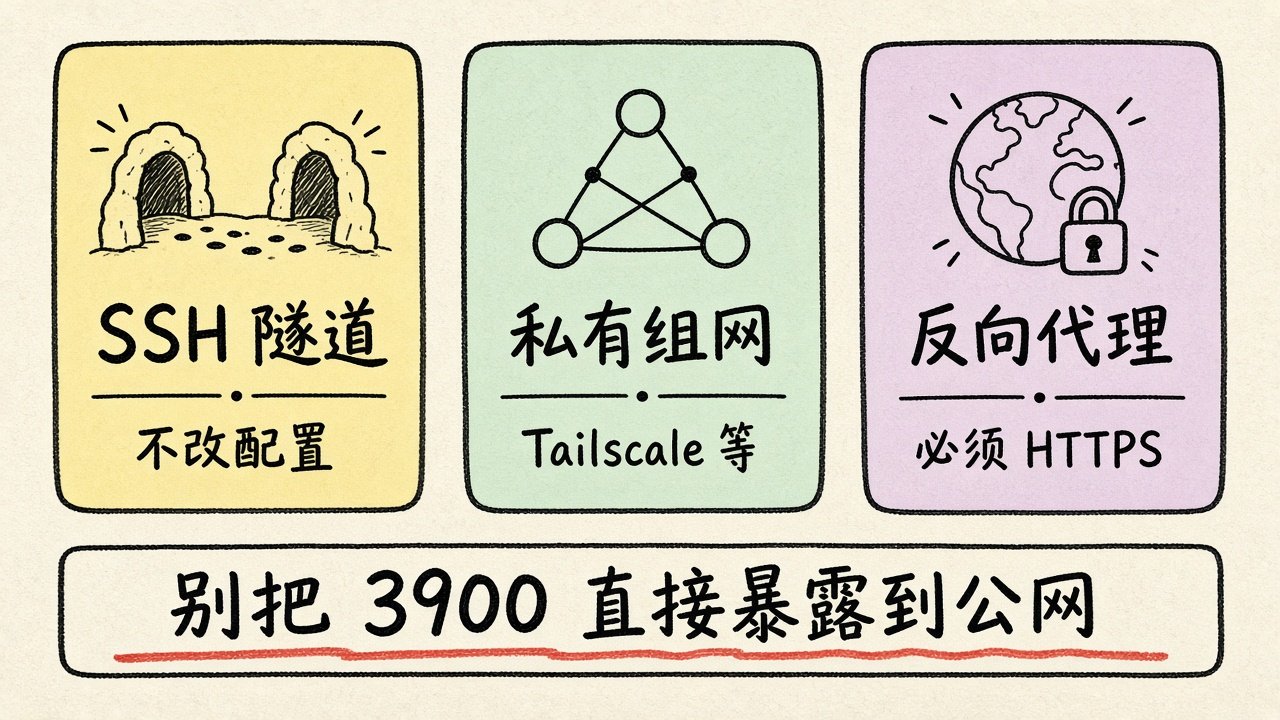
按安全程度从高到低,有三种连法。
SSH 隧道。 不改任何配置,在你自己的电脑上执行(这条是通用 SSH 用法,不是项目文档里的):
ssh -L 3900:127.0.0.1:3900 用户名@服务器IP
连上以后,在自己电脑浏览器打开 http://localhost:3900 。关掉 SSH,通道就断了。
Tailscale 这类私有组网。 项目文档写了它返回的是相对地址,放在 Tailscale 或反向代理后面也能用。本站之前有一篇用 Tailscale 搭回国通道的教程,装法一样,装好后用 Tailscale 分配的地址访问。这种方式需要把端口从 127.0.0.1 改成能被组网网卡访问到。
域名加反向代理。 要改端口映射,再配 HTTPS。如果网页和接口放在不同域名下,文档要求设两个变量:
docker run -e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" \
  -e OMNIVOICE_PUBLIC_API_BASE=https://api.your-host.example \
  -e OMNIVOICE_ALLOWED_ORIGINS=https://ui.your-host.example \
  -p 0.0.0.0:3900:3900 \
  ghcr.io/debpalash/voicestudio:stable
有一条我建议当成硬规矩:不要把 3900 端口直接用 http 暴露到公网。compose 文件的注释原话是流量一离开完全可信的局域网,就要用 HTTPS 或加密的私有网络。API Key 只能证明你是谁,挡不住别人在路上看到你的请求。
9. 能不能让脚本或 AI 助手调用它?
这是它和一般配音软件差别最大的地方。后端在 3900 端口上开了几种接口,docs/speech-platform.md 里列了这些:
- OpenAI 兼容的转录接口:
POST /v1/audio/transcriptions,现成的 OpenAI SDK 改个地址就能用 - 实时转录 WebSocket:
/v1/audio/transcriptions/stream - MCP:
POST /mcp/,给 Claude Code、Codex 这类助手接
先用这条命令看它支持什么:
curl http://127.0.0.1:3900/.well-known/voicestudio-speech
文档写的是本机回环地址的调用不用带凭据,远程调用要带上 Key。不过第 4 问说过,Docker 的地址转换会让后端看不出请求来自本机,所以容器部署时我建议脚本一律带上 Authorization: Bearer $OMNIVOICE_API_KEY,省得被拒了再排查。
10. 声音克隆有哪些不能碰的?怎么更新和卸载?
先说授权。README 里 License 那一节的原话是 Clone voices only with permission,只克隆你获得许可的声音。软件本身是 AGPL-3.0,可以商用,但要满足 AGPL 的条件;模型权重、音色和生成内容的使用条件另算,在 Model Manager 里能看到各个模型的来源说明。拿它给自己的视频配音没问题,拿别人的声音去做东西之前,先把授权问清楚。
还有一个设置:文档说产品分析默认需要你在首次启动时同意才会打开,想彻底关掉,启动时加 -e OMNIVOICE_ANALYTICS_DISABLED=1。
更新。compose 部署的,在仓库目录下执行:
docker compose -f deploy/docker-compose.yml --profile cpu pull
docker compose -f deploy/docker-compose.yml --profile cpu up -d
docker run 部署的,先 docker pull 新镜像,再删掉旧容器、用原来的命令重建。数据存在 omnivoice-data 这个卷里,删容器不会丢模型和项目。
卸载。下面是 Docker 的通用命令:
docker rm -f omnivoice
docker volume rm omnivoice-data   # 这一步会删掉已下载的模型和你的项目,确认不要了再执行
我这次没有动手部署,上面这些是对着官方文档一条条核过的。哪位在 2 核 4 GB 的纯 CPU 小鸡上跑过,生成一段 30 秒的配音要多久,欢迎在评论区告诉我一个真实数字。
来源:
- 项目仓库 https://github.com/debpalash/VoiceStudio (README、docs/install/docker.md、deploy/docker-compose.yml、docs/speech-platform.md、docs/downloading-models.md)
- v0.5.7 发布页 https://github.com/debpalash/VoiceStudio/releases/tag/v0.5.7
- GitHub Trending 日榜 https://github.com/trending (2026-10-27 14:56 北京时间抓取)


