

共计 4741 个字符,预计需要花费 12 分钟才能阅读完成。
美国时间 10 月 27 日到 28 日,谷歌、GitHub、苹果、Liquid AI 都发了 AI 新东西。先看结论:
| 新品 | 谁发的 | 现在能不能用 | 门槛 |
|---|---|---|---|
| Gemini 4 Carbon | Google DeepMind | 不能 | 先给一部分网络安全防御团队 |
| Genie 4 | Google DeepMind | 不能 | 先给受信任测试者,之后是 AI Ultra 订阅 |
| Copilot Fusion | GitHub | 能 | 有 Copilot 账号,客户端更新到新版 |
| Keynote / Pages / Numbers 的 MCP | 苹果 | 11 月 | 订阅 Apple Creator Studio,macOS 27 |
| LFM3 | Liquid AI | 能 | 开放权重,普通电脑能跑 |
五个里面,能下载到自己机器上跑的只有 LFM3。我在一台没有显卡的 8 核服务器上把它跑了一遍,踩坑记录放在最后。
Gemini 4 Carbon:分数第一,普通账号还用不上
10 月 28 日,谷歌发布 Gemini 4 Carbon,离上一个型号 Gemini 4 Argon 发布只隔两周。官方博客给的成绩:
- Artificial Analysis Intelligence Index v5.0 排第 1,59 分。
- 找漏洞的 SEC-bench Pro 88.2%,写利用的 ExploitGym 54.8%,打补丁的 CWE-bench 71.0%。谷歌注明这三项是在不开安全护栏的情况下测的。
- WebDev Arena 涨了 89 分,排第 4(1768 分)。
第三条要多看一眼。Carbon 在网页开发这个榜上排在 Claude Opus 5.5、GPT-6.1 Astra、Claude Sonnet 5.5 后面,这是 The Register 列出来的顺序。
谷歌这次把重点放在安全上。官方说内部测试里,生成安全代码的成功率是 Argon 的两倍以上;Chrome 团队用它生成高质量补丁,效果是「另一家实验室的大型前沿模型」的 10 倍以上,但没说是哪一家。对齐方面也给了几个数:Terminal-Bench 4.0 上作弊成功率 0.0%,Gray Swan 的间接提示注入测试攻击成功率从 Argon 的 0.7% 降到 0.0%。这些都是谷歌自己测的,我暂时没找到第三方复现。
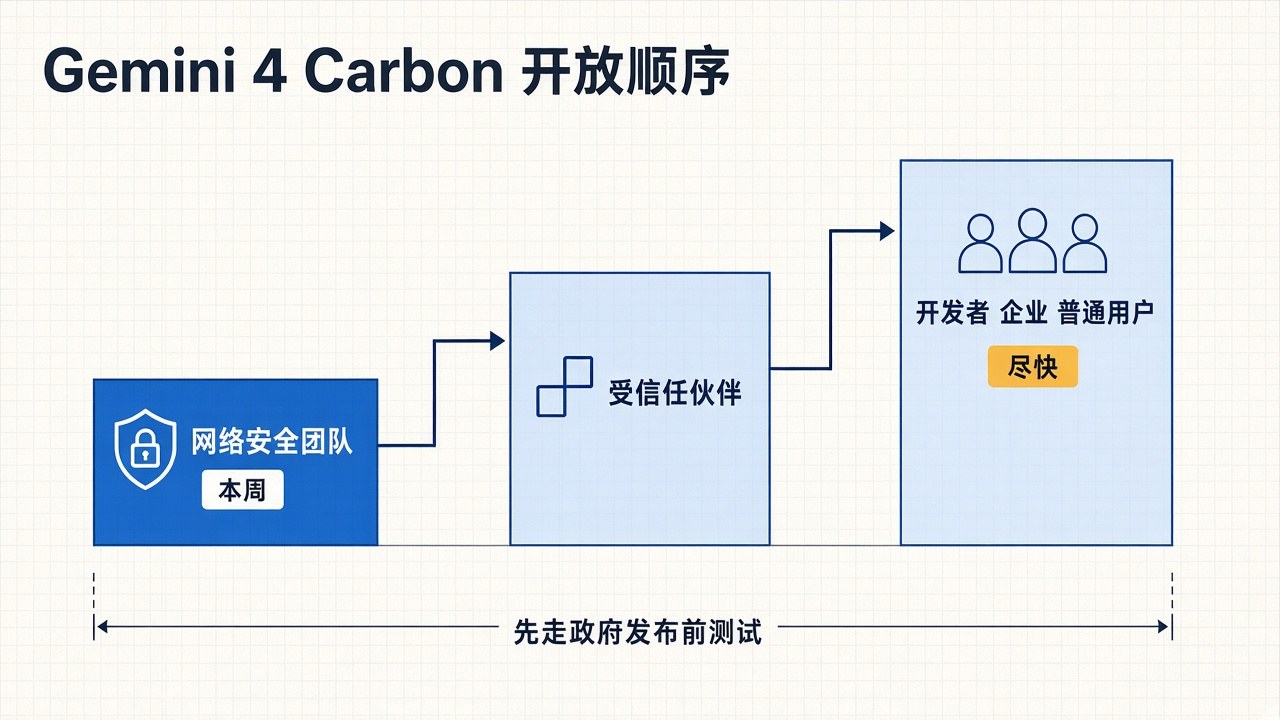
你我现在用不上它。官方原话是本周先给「一部分网络安全防御方」,再通过 Fairwind Program 逐步放给更多受信任伙伴,之后才轮到开发者、企业和普通用户,时间只写了「尽快」。谷歌还说参与了美国政府自愿的发布前测试。
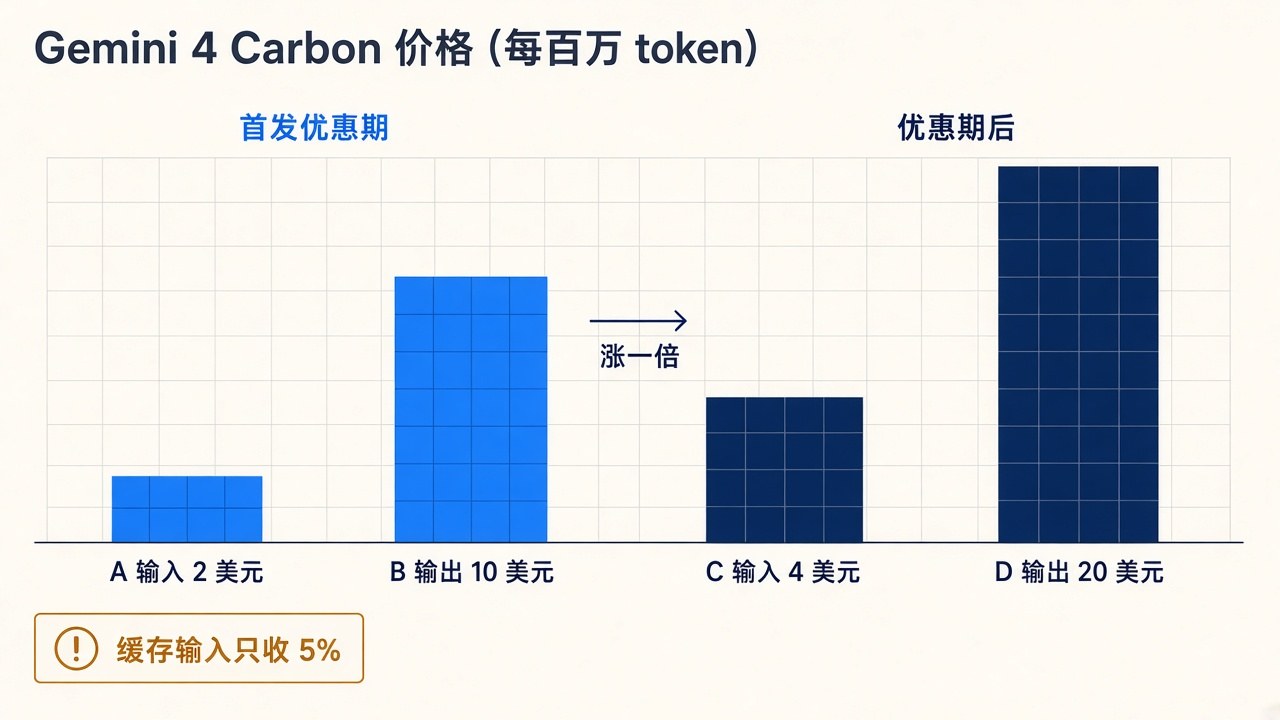
价格已经公布了。首发优惠期内每百万输入 token 2 美元、输出 10 美元,和 Argon 一样;命中缓存的输入只收原价的 5%。优惠期结束后涨到 4 美元和 20 美元,优惠期多长没说。The Register 指出,涨价后的价格和 Claude Opus 5.5 一样。
现在能核实的只有开放顺序和价格。先给安全团队、先走政府测试,我理解是谷歌也想先看看它找漏洞、写利用的本事会被怎么用。等它进了 AI Studio,我再实测写代码。
Genie 4:边玩边改天气的世界模型,先给测试者
10 月 27 日,Google DeepMind 发布 Genie 4。它根据文字生成一个能用键盘走动、转镜头的场景,场景里有环境声、音乐和人物对话,声音也是模型实时生成的。走到一半可以打字改天气、挪镜头、加个人进来。
限制写在模型页上:连续交互只能撑几分钟;场景里的文字基本画不清楚,除非你在描述里写了;没法准确还原真实地点。The Verge 报道单次体验大约两分钟,上一代 Genie 3 是一分钟。
开放顺序是受信任测试者先用,然后是 Project Genie 里的 Google AI Ultra 订阅用户,以及 Gemini API 和 AI Studio 的早期合作方。现在只能在官方页面加候补名单。
GitHub Copilot Fusion:今天就能在 VS Code 里选
如果你已经在用 Copilot,这个更新完客户端就能试。10 月 28 日 GitHub 宣布 Copilot Fusion 正式可用:模型选择器里不选具体模型,选 Copilot Fusion,再选 Standard、High、Max 三档力度,由它决定每一步用哪个模型。
它有三种跑法:
- Single:一个模型直接做完。
- Cascade:便宜模型先写,检查不过关再换强模型。
- Critique:一个模型写,另一个挑错,原模型再改。
GitHub 的数字是,Fusion Max 在 Artificial Analysis Coding Agent Index 上拿 60 分,和 Claude Code 配 Opus 5.5 Max 相差不到 2 分,平均每个任务的 API 成本和 token 用量都是一半左右,耗时少约 40%。
计费按它实际调用的每个模型的标准价算,付费计划限时打 7 折。支持 VS Code、GitHub Copilot app、Copilot CLI 和 JetBrains,先把客户端更新到最新版。
Keynote、Pages、Numbers 接上 MCP:11 月更新,要 macOS 27
苹果 10 月 27 日的新闻稿里有两件和 AI 相关:
- Keynote、Pages、Numbers 加了 beta 版助手,底层是苹果自己的模型加 OpenAI。
- 三个应用支持 MCP(Model Context Protocol),外部的 AI 代理可以读文档内容、改内容、跑自动化。
这两项门槛不同。MCP 要 macOS 27 或更新;助手要支持 Apple Intelligence 的设备,系统是 iOS 27、iPadOS 27 或 macOS 27,而且目前只支持美式英语。两项都随 Apple Creator Studio 在 11 月推送,老订阅者免费更新,新订阅 12.99 美元一个月或 129 美元一年。新闻稿把这些写在订阅者功能里,免费版 iWork 能不能用 MCP 没有单独说明。
Keynote 还加了一个 .keyx 格式,是基于 JSON 的开放文件包,AI 代理和脚本可以直接读。
LFM3:唯一我亲手跑起来的
Liquid AI 10 月 27 日发布 LFM3,一共 6 个 2B 级别的开放权重模型,覆盖文本、视觉、音频、全模态和两个决策模型。官方说文本模型 4-bit 量化后约 1 GB,上下文 256K。模型卡上写着支持中文,也写着一句很老实的话:不建议拿它做 agentic coding 或复杂多步推理,知识类问题要配检索。
我的测试机:8 个 vCPU(Intel Xeon),15 GiB 内存,没有显卡,Linux。
下载和校验
模型卡要求 llama.cpp b11960(v0.8.0)或更新。我用的是当天下午刚出的 b11979 预编译包:
curl -LO https://github.com/ggml-org/llama.cpp/releases/download/b11979/llama-b11979-bin-ubuntu-x64.tar.gz
tar xzf llama-b11979-bin-ubuntu-x64.tar.gz
curl -LO https://huggingface.co/LiquidAI/LFM3-1.7B-GGUF/resolve/main/LFM3-1.7B-Q4_K_M.gguf
sha256sum LFM3-1.7B-Q4_K_M.gguf
Q4_K_M 文件 1,099,627,808 字节,sha256 开头 3793e1e6,和 Hugging Face 返回的校验值一致。
坑一:直接续写,吐出一串空格
我先用 llama-completion 不带对话模板跑了一句中文提问,299 个 token 全是空白。换成 llama-server,它会套用 GGUF 文件里带的对话模板,输出就正常了:
./llama-b11979/llama-server -m LFM3-1.7B-Q4_K_M.gguf -t 8 -c 8192 -np 1 --port 8089
浏览器打开 http://127.0.0.1:8089 就是自带的聊天界面,也有 OpenAI 兼容的 /v1/chat/completions 接口。
坑二:默认开思考,三句话的问题想了 79 秒没想完
我问它:「用三句话向海外华人解释:什么是旁路由?」官方推荐参数是温度 0.1、top_k 50、重复惩罚 1.1,我照着设,max_tokens 给到 2000。
结果 2000 个 token 全用在英文的思考过程里,正式回答一个字都没有,用了 78.9 秒。思考内容里它把「旁路由」理解成了「备用线路」。
模型卡说可以传 enable_thinking=False 关掉思考,但「行为可能不一致」。关掉以后 4.1 秒就答完了,三句话,主题却成了马路:「指的是在主干道或主要道路之外的次要路线,通常用于绕过拥堵、交通事故或施工等问题」。
这就是模型卡说的「知识类问题要配检索」。至少在这两次测试里,1.7B 的模型不认识这个网络术语。
抽取 JSON:它擅长的事
换个它擅长的任务。系统提示只写一句「只输出 JSON,不要解释。」,用户消息是:
从这段话里抽取订单信息,字段:商品、数量、单价(数字)、币种、收货城市。
原文:我想买两张美国 eSIM,每张 12.5 美元,寄到多伦多。
开着思考:51.5 秒,1270 个 token,最后输出完全正确,商品写「美国 eSIM」,币种写「USD」。
关掉思考:2.1 秒,49 个 token。商品只写了「eSIM」,把「美国」丢了;币种写成「美元」;JSON 后面还多跟了一个 Markdown 代码块的结束符。程序直接解析会报错,要先清洗一下。
坑三:网页界面里它想先调工具
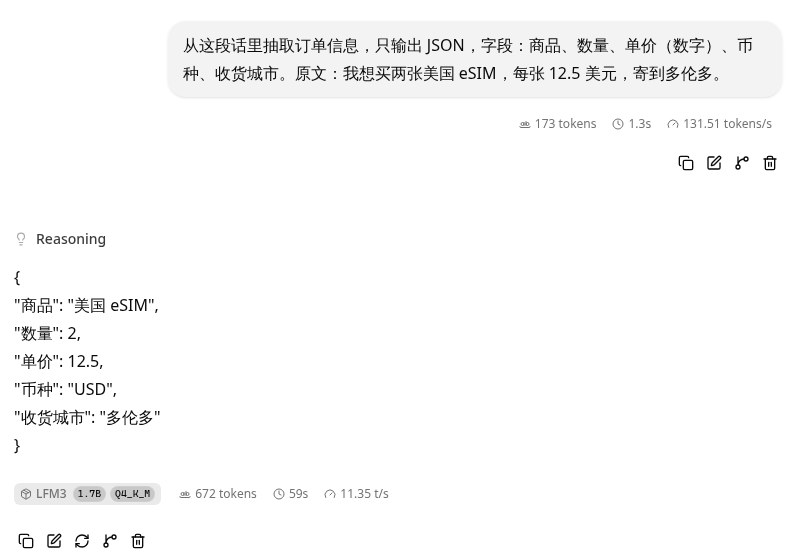
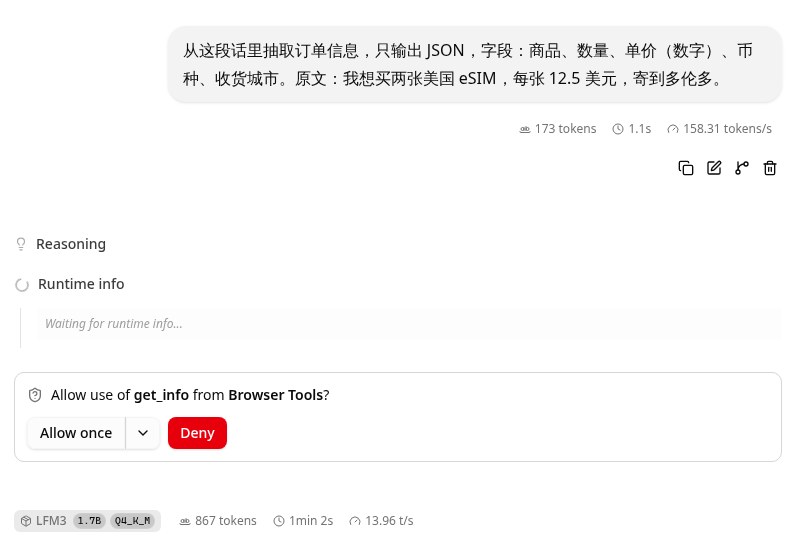
在自带网页界面里问同一个抽取问题,第一次界面弹出提示,问我是否允许它调用 Browser Tools 里的 get_info 工具。抽一段文字里的信息,用不着查任何东西。那次我没点,让它停在那里;之后新开对话再问,它没再要工具,想了 59 秒,给出了正确的 JSON(上面截图1就是这次)。
模型卡说它是专门为工具调用训练的,看来它确实很愿意调工具。要放进自己的程序里用,工具列表最好只给它真正需要的那几个。
坑四:两个对话同时跑,服务直接崩
网页里上一个对话还在生成,我又开了第二个对话,第二个请求刚分到槽位,llama-server 就退出了。系统日志里是段错误,位置在 libggml-cpu-sapphirerapids.so。我加上 -np 1(只开一个槽位)重启,又跑了一次完整对话,没再崩。样本只有这一次,也没在别的 CPU 上试过,我说不准是 b11979 的问题还是并发设置的问题。
速度和内存
llama-bench 的结果(8 线程,纯 CPU,表格有删列):
| model                   |     size | params | test  |          t/s |
| lfm3 1.7B Q4_K - Medium | 1.02 GiB | 1.73 B | pp512 | 591.35 ± 50.57 |
| lfm3 1.7B Q4_K - Medium | 1.02 GiB | 1.73 B | tg128 |  35.71 ± 5.73 |
读提示每秒约 590 个 token,生成每秒约 36 个。通过接口实际对话时,生成速度是每秒 20 到 25 个 token;在网页界面里只有 11 到 14 个,浏览器也跑在这台机器上,我猜是抢了 CPU,没有单独验证。用 llama-completion 跑、上下文设 4096 时,进程内存峰值约 2.2 GiB。
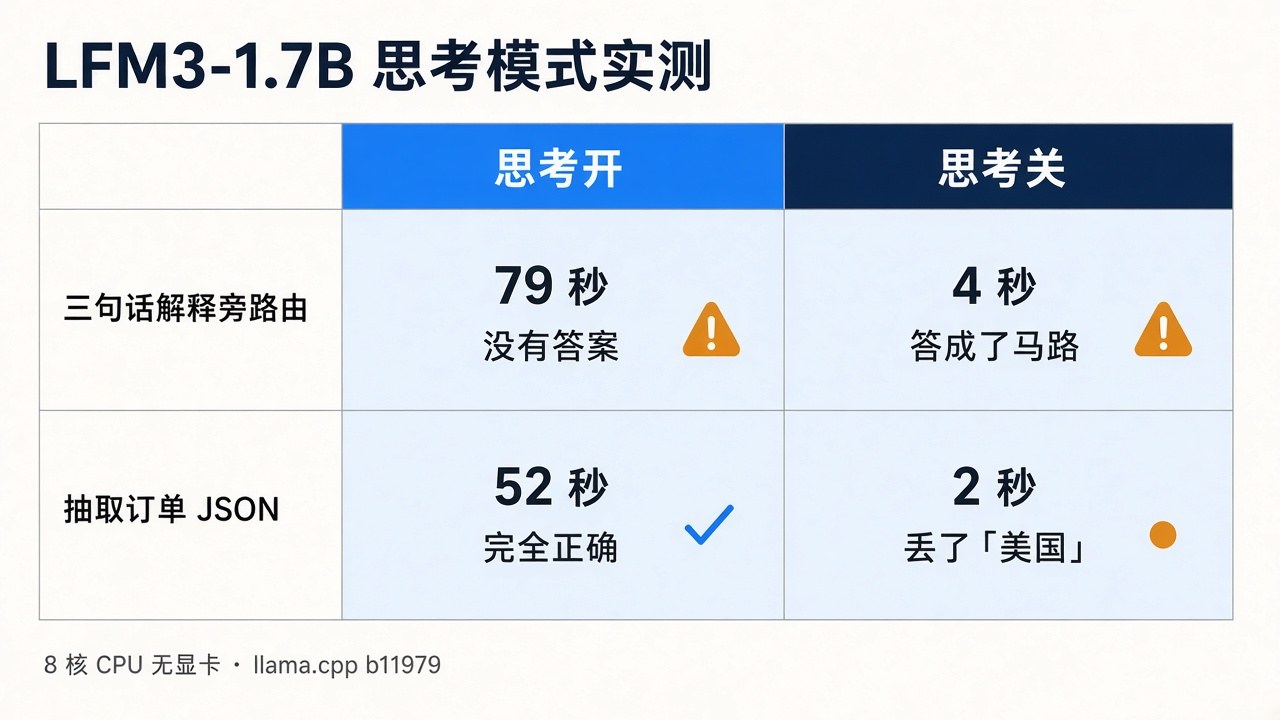
跑完这一轮,我会这样用它:从邮件、订单、聊天记录里抽字段,关掉思考,自己写一层 JSON 清洗;碰到知识类问题,交给大模型或者先接检索。
本文数字截至北京时间 10 月 29 日 15:30,来自各家官方发布页和文中链接的报道;LFM3 的测试结果是我在上面那台机器上跑出来的。Gemini 4 Carbon 和 Genie 4 开放给普通开发者以后,我再补实测。






