

共计 4710 个字符,预计需要花费 12 分钟才能阅读完成。
MarkItDown 是微软开源的一个 Python 工具,用来把 PDF、Word、Excel、PowerPoint,以及 HTML、CSV 这类文件转成 Markdown。仓库在 microsoft/markitdown,许可证是 MIT,当前 PyPI 稳定版是 0.1.9。
官方 README 把用途说得很清楚:它面向大模型和文本分析流水线,会尽量保留标题、列表、表格和链接。输出对人来说往往还算能看,但不是高保真排版转换的最佳选择。图片说明和语音转写要依赖在线服务。我这次没有接任何钥匙,也没有调用这两项。
我要解决的事情比较具体。手头如果同时有一份说明、一张表和几页幻灯片,直接复制经常把标题层级和表格弄乱。先收成一份能打开、能复制的 Markdown,后面要贴进笔记软件,或者再交给模型处理,都比较省事。2026年11月20日上午,我在自己的 Linux 测试机上把 0.1.9 装进虚拟环境,用四份自己写的练习文件转了一遍。同一天从 GitHub API 读到这个仓库有 197,026 星,Python 日榜上它排在第 11、当日新增 526 星。星数只说明关注度,下面仍以这四份文件的实际输出为准。
🍎 按官方说明,MarkItDown 会以当前进程的权限做读写,不信任的输入要先处理。只转本地文件时,官方建议调用更窄的 convert_local() 或 convert_stream(),不要一上来就把来路不明的路径丢给更宽的 convert()。
建虚拟环境 → 安装 0.1.9 → 准备四份自建文件 → 命令行转换 → 对照原文
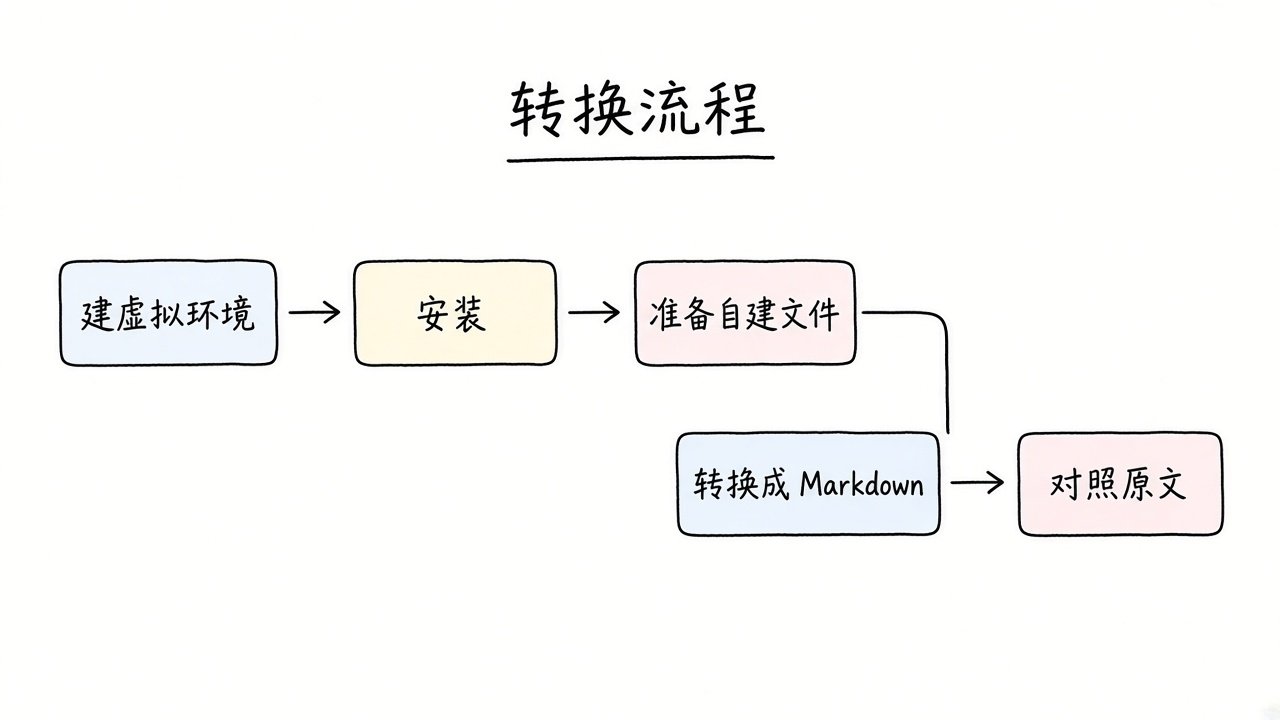
▲ 这次的实际顺序:建虚拟环境 → 安装 → 准备自建文件 → 转换成 Markdown → 对照原文。
PART 01
安装时实际落到的版本
官方要求 Python 3.10 到 3.14,并建议用虚拟环境。我这台机器是 Python 3.13.5,安装按 README 的完整依赖来,同时把版本钉在当前稳定版:
python -m venv .venv
source .venv/bin/activate
pip install 'markitdown[all]==0.1.9'
只想转其中几种格式时,官方也提供按需安装,例如 pip install 'markitdown[pdf, docx, pptx, xlsx]'。Windows 的命令提示符里,这类方括号写法通常要改成双引号。我没有在 Windows 或 macOS 上装过,这两处只引官方说明,不当自己的结果写。
这次实际装到的就是 markitdown==0.1.9。跟转换关系比较直接的依赖包括:pdfminer.six==20260107、pdfplumber==0.11.10、mammoth==1.13.0、openpyxl==3.1.5、python-pptx==1.0.2、pandas==3.1.1。[all] 还会带上 Azure、语音识别、YouTube 转写这些可选组件,我没有配置相关账号,后面也没有用它们。
装完后执行 markitdown --help,能打印出用法,markitdown -v 对应 0.1.9。v0.1.9 的 GitHub Release 发布时间是 2026-10-21T19:40:32Z,也就是北京时间 2026年10月22日 03:40:32。
PART 02
四份练习文件是怎么做出来的
测试文件全部是自己写的短样本,没有下载书籍、新闻或网文。生成用的是本机已有的 python-docx 1.2.0、openpyxl 3.1.5、python-pptx 1.0.2,PDF 则由 LibreOffice 把其中一份 Word 导出。中文字体用的是系统里的 Noto Sans CJK SC。
- 回国行李清单.pdf:先写成 Word,再执行
soffice --headless --convert-to pdf packing-list.docx。一页中文,带标题、两组列表、一张三列表格,正文里混排了 Passport、USB-C、Type A to Type I 这些英文。页眉写「练习样本 · 仅供格式转换 · 非真实行程」,页脚写「回国行李清单 第 1 页」。行程是编的,只为了看结构能不能留下来。 - 周末家庭开支说明.docx:正式的一级标题、两个二级标题,下面分别是项目符号列表和编号列表。页眉页脚同样有练习标记。
- 汇率换算练习.xlsx:工作表名是「汇率换算练习」,表头为币种、外币金额、汇率(兑人民币)、折合人民币。三行数据是 USD 100 × 7.10、EUR 50 × 7.75、JPY 10000 × 0.047,合计用
SUM。这些汇率是为练习编的近似数字,不是银行牌价。 - 回国行前准备.pptx:三页。封面写标题,后两页分别是「出发前三件事」和「需要携带的文件」,每页几条要点。
python-docx / openpyxl / python-pptx 写出源文件 → LibreOffice 导出 PDF → 交给 markitdown
PART 03
PDF 行李清单:字还在,表格散了
命令和第一次记录的耗时如下。退出码是 0。
markitdown src/packing-list.pdf -o out/packing-list.md这次 CLI 跑完用了 0.819 秒,输出 416 个字符。标题「回国行李清单(练习样本)」还在,中英文也都正常,没有乱码。但标题只是普通段落,没有变成 Markdown 的 # 一级标题。「托运行李」「手提行李」这两个小标题同样没有变成 ##。
列表项前面的项目符号,源文件里是 LibreOffice 写入的私有区字符 U+F0B7,转换后原样留着,并没有改写成 Markdown 的 - 或 *。在一部分终端和编辑器里,这个字符会显示成方框。
表格是这次亏得最明显的地方。原文件里是「物品 / 数量 / 备注」三列,转出来变成三段竖着排的文字:先是物品名,再是三个 1,接着是备注。行列对不上了,要当表格用得自己重新排。页眉和页脚都被读进了正文;正文里 “November 2026” 还在 “November” 后面被断开,单独成了下一行。
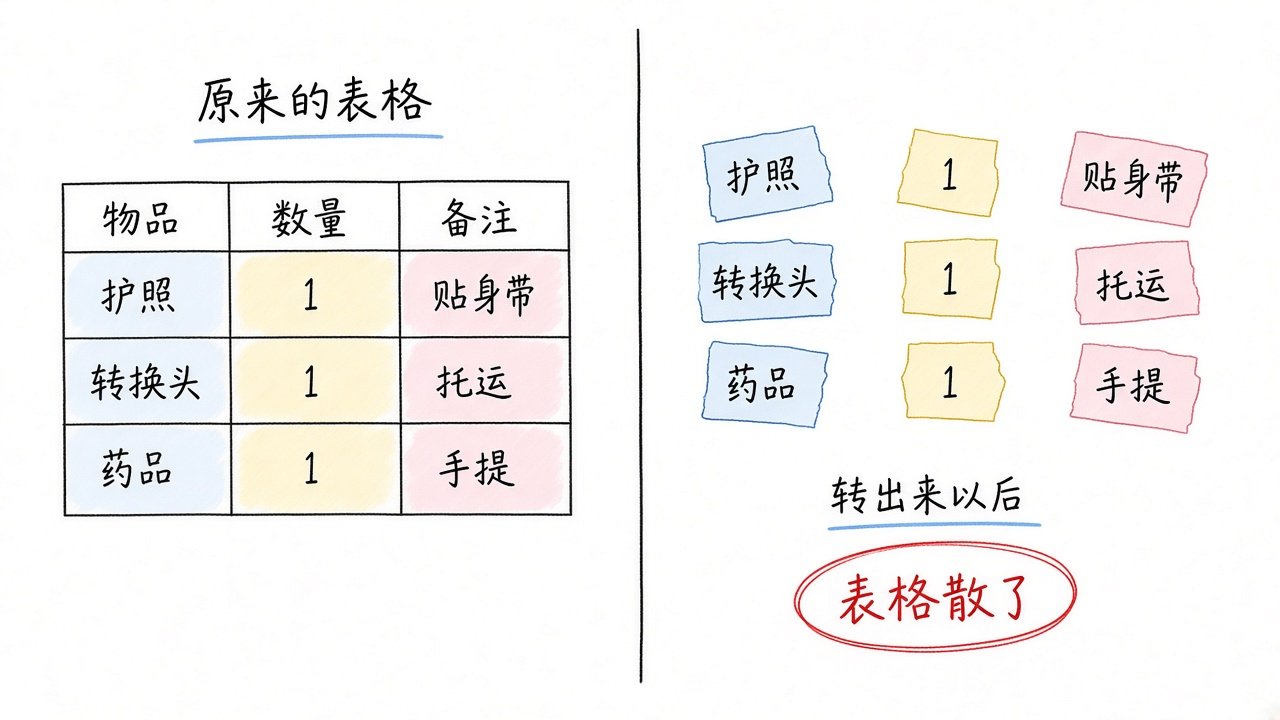
▲ 示意图:左边是整齐的三列表格,右边同一张表被拆成几堆文字。
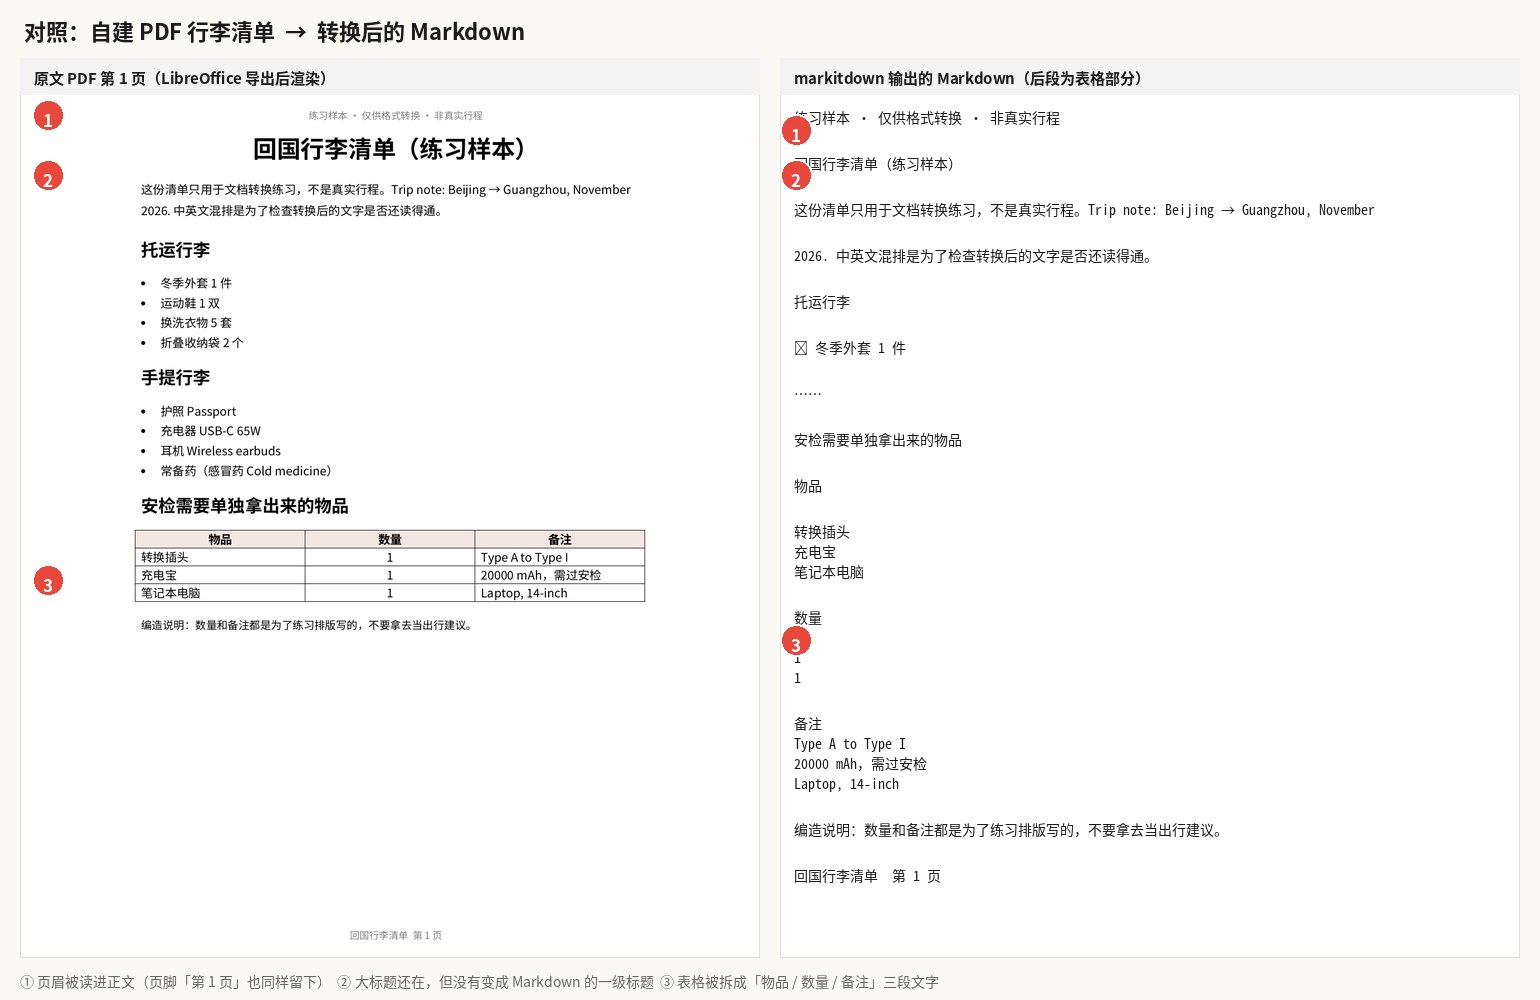
▲ 左:练习 PDF 第 1 页;右:markitdown 输出原文。① 页眉进了正文,页脚「第 1 页」同样留下;② 大标题还在,但不是一级标题;③ 表格被拆成三段文字。
同一份 PDF,我又用 Python 接口按官方建议调用了只读本地文件的方法:
from markitdown import MarkItDown
md = MarkItDown(enable_plugins=False)
result = md.convert_local("src/packing-list.pdf")
print(result.markdown)
这次用了 0.043 秒,得到的文本和命令行那份完全一样,也是 416 个字符。接口本身没有把表格修好,它只是换了一种调用方式,并且把读写范围收得更窄。
PART 04
Word 最完整,Excel 的公式先是空的
Word 这份最省心。
markitdown src/weekend-expense-guide.docx -o out/weekend-expense-guide.mdCLI 用了 0.825 秒,退出码 0。一级标题变成了 #,两个二级标题变成了 ##,项目符号列表写成 *,编号列表写成 1. 2. 3.。中文正常,正文一段也没丢。标题外面还包了一层 **加粗**,不影响阅读。页眉「练习说明 · 仅供格式转换」和页脚「第 1 页」没有出现在输出里。若你希望页眉页脚一并留下来,这次的 Word 结果做不到,得自己补。
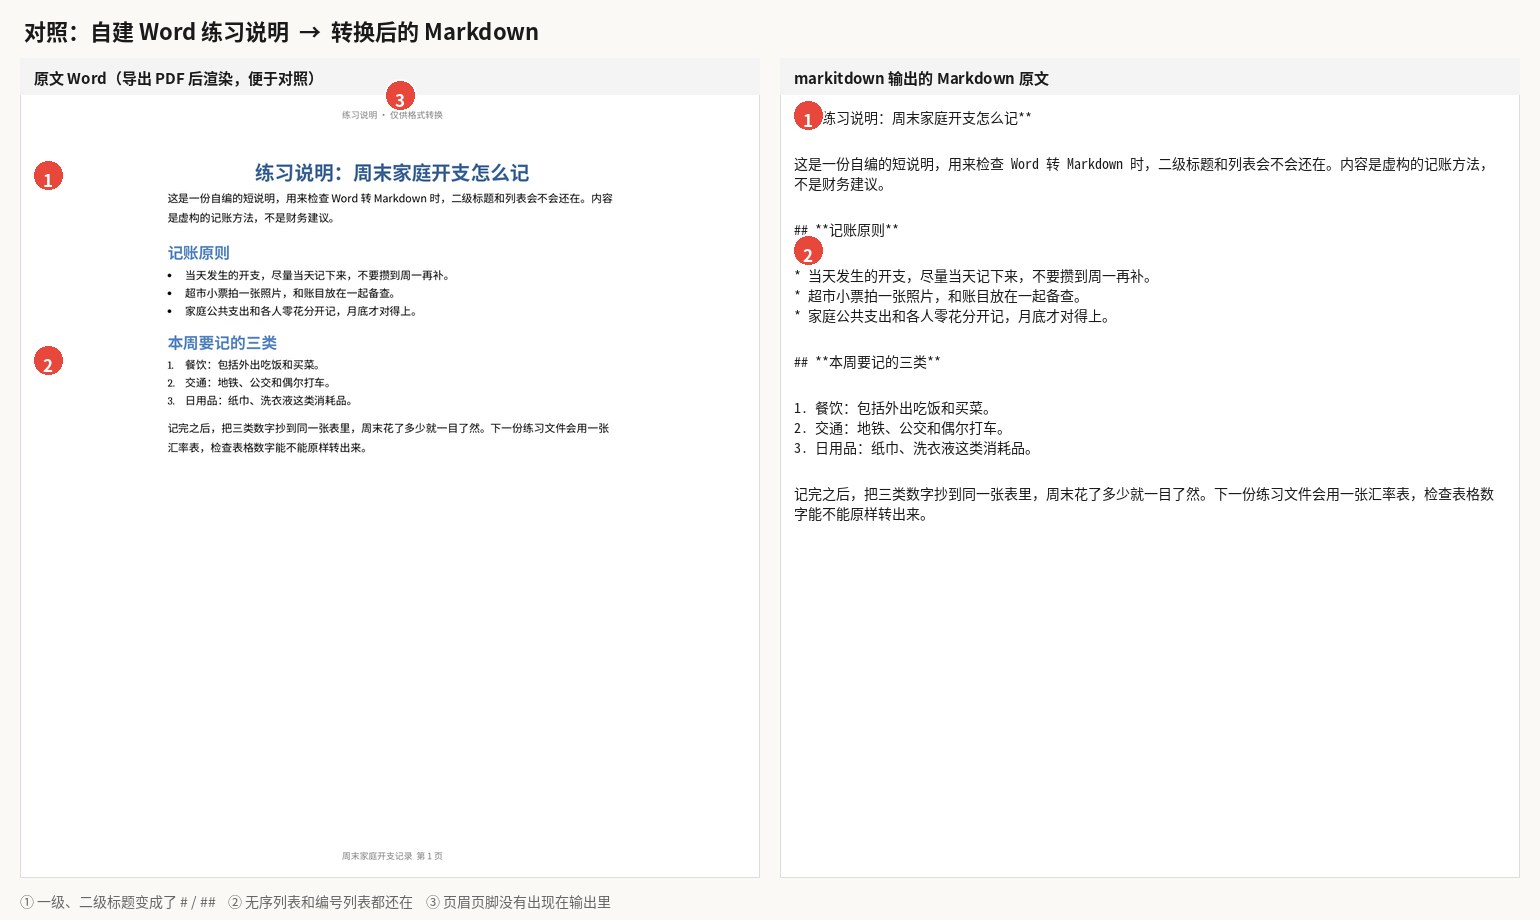
▲ 左:Word 导出后的页面;右:转换结果。① 标题层级还在;② 两种列表都在;③ 页眉页脚没有进 Markdown。
Excel 第一次就踩到坑。
markitdown src/fx-conversion-practice.xlsx -o out/fx-conversion-practice.mdCLI 用了 0.694 秒,退出码 0。工作表名变成了 ## 汇率换算练习,表头和 USD、EUR、JPY 三行金额、汇率都在,中文正常。可是「折合人民币」和「合计」全是 NaN。原因很直接:我用 openpyxl 写入的是公式,文件里还没有算出的缓存值,MarkItDown 读到的就是空结果。合并后的标题行还被垫进同一张 Markdown 表,多出了 Unnamed: 1 这样的空列,空白行则变成一整排 NaN。汇率 7.10 被写成 7.1,只是小数末尾的 0 被去掉,数值没变。
解决办法是让计算结果先写进文件。我把同一份表在 LibreOffice 里转成 ods 再转回 xlsx,等于让表格软件算一遍并保存。再转一次之后,折合人民币变成 710、387.5、470,合计 1567.5,和我预先算的 100×7.10、50×7.75、10000×0.047 一致。Unnamed 空列和多余的 NaN 格子还在,需要的话可以手工删掉。直接把算好的数字写进单元格,效果和另存一次相同。
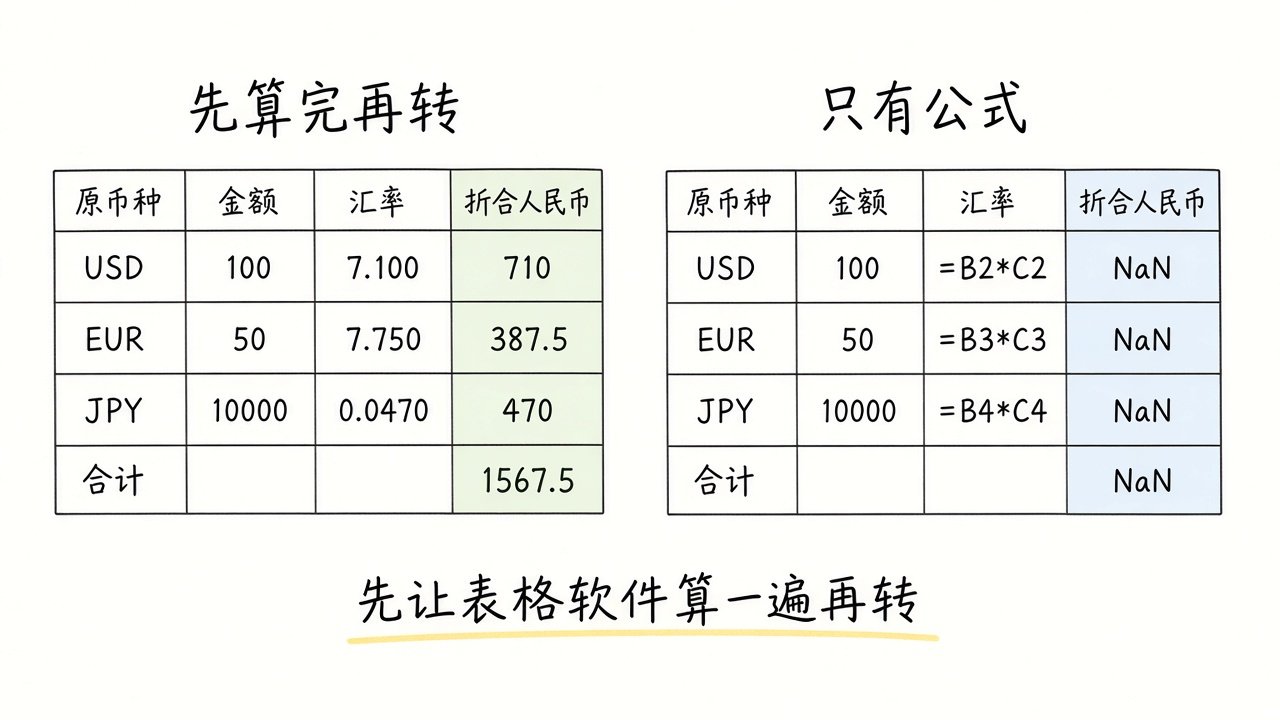
▲ 示意图:左边是先算完再转得到的 710、387.5、470 和合计 1567.5;右边只有公式时,这一列会变成 NaN。这些是练习数字,不是牌价。
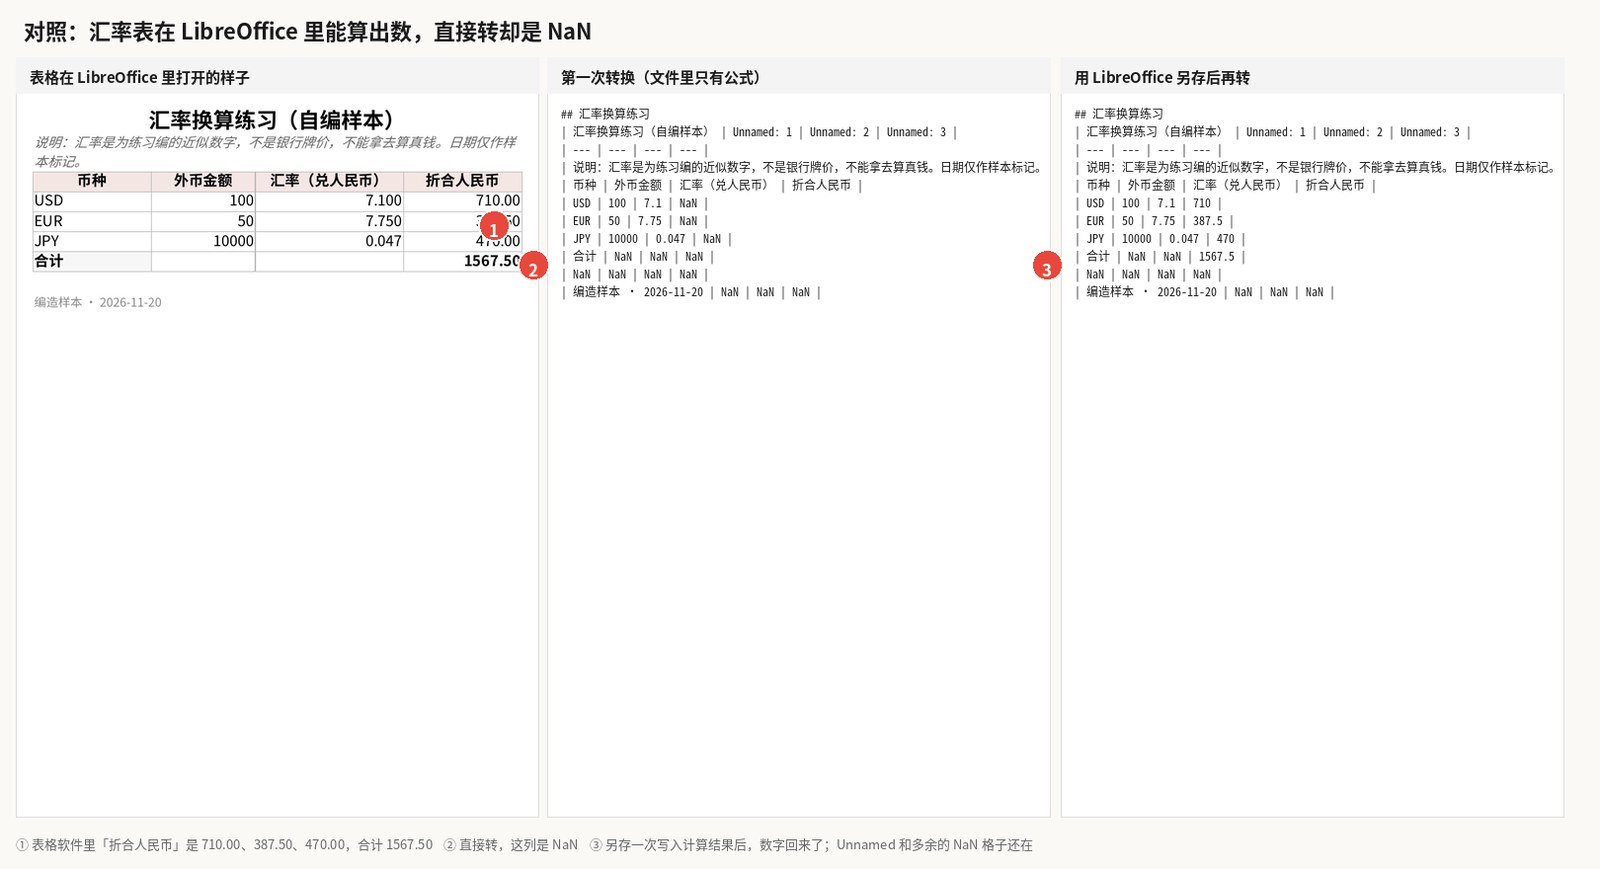
▲ ① 在 LibreOffice 里,折合人民币是 710.00、387.50、470.00,合计 1567.50;② 直接转换时这列是 NaN;③ 另存一次写入结果后,数字回来了。
PART 05
幻灯片变成带页码的纯文本
markitdown src/trip-prep-practice.pptx -o out/trip-prep-practice.mdCLI 用了 0.761 秒,退出码 0。三页内容都在,中英文正常。每一页前面会留下一行 HTML 注释,例如 <!-- Slide number: 1 -->。封面标题「回国行前准备(练习幻灯片)」以及后面两个小节标题,都只是普通段落,没有变成 # 或 ##。要点也没有写成列表,只是一行一行排下来。若你的目的是把幻灯片里的句子抽出来复制,这样已经够用;若想保留演示文稿的层级和项目符号,还得自己加标记。
这四份文件的第一次系统转换,我是一次性记下命令、耗时和退出码的。后来为了截终端,又在同一台机器上把这四条命令跑过一遍,截图里的耗时是 0.760、0.787、0.670、0.665 秒,结果文本与第一次一致,只是时间会有零点几秒的出入。
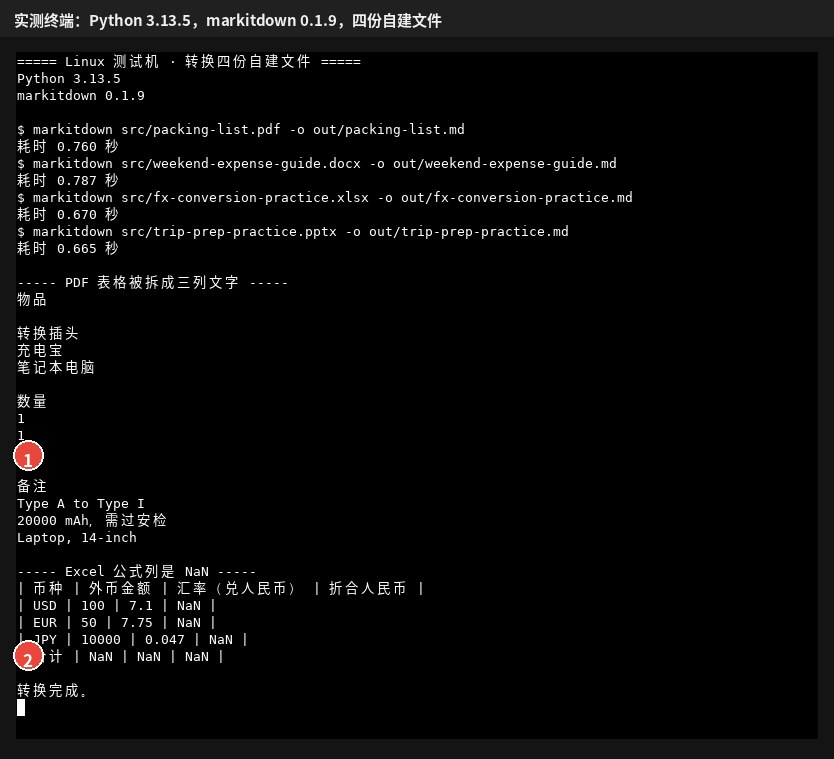
▲ 实测终端。① PDF 表格被拆成「物品 / 数量 / 备注」三段;② Excel 公式列是 NaN。截图为同一次流程的再次运行。
官方已经把边界写在前面了。对照这四份自建样本:Word 最能保住标题和列表。PDF 能抽出文字和中英文,表格、列表符号和页眉页脚却都不按 Markdown 结构来。Excel 能保住表头和原始数字,但公式要先算完再转。PowerPoint 能抽出每页的句子,并标上页码,标题和列表则要自己补标记。这些文件里都没有图片,我看不到它会不会留下图片说明。官方写明图片说明和语音转写要走在线服务,我没有为了演示去调用。
写在后面
如果你要把一批本地的 Word、表格或文字层 PDF 收成可复制的 Markdown,再拿去检索或交给模型,MarkItDown 0.1.9 在 Linux 上可以本地装、本地转,不一定非要开通云服务。它不是排版还原工具。拿到输出之后,PDF 的表格、Excel 多出来的空列,仍然建议对一下原文。
我只用 Linux 测试机跑通了上面这些步骤。Windows 和 macOS 的安装方式以官方 README 为准,我没有在那两套系统上复现。仓库地址是 microsoft/markitdown,PyPI 页面是 pypi.org/project/markitdown。
若你要先准备一份练习用的 PDF,再去做别的流程,可以参考站内已经写过的 在 Linux 上把一份练习 PDF 从上传签到出证。那一篇讲的是电子签名,不是转换,和这次的样本文件也不是同一份。






