

共计 7314 个字符,预计需要花费 19 分钟才能阅读完成。
赌约是这样定的。
每天下午两点,给模型看过去 400 根 BTC-USDT 的 1 小时 K 线,让它说出接下来 24 根的收盘价。我不看它答案的过程,只看两件事:第 24 根收盘时它说的涨跌对不对,24 根加起来平均差了多少美元。
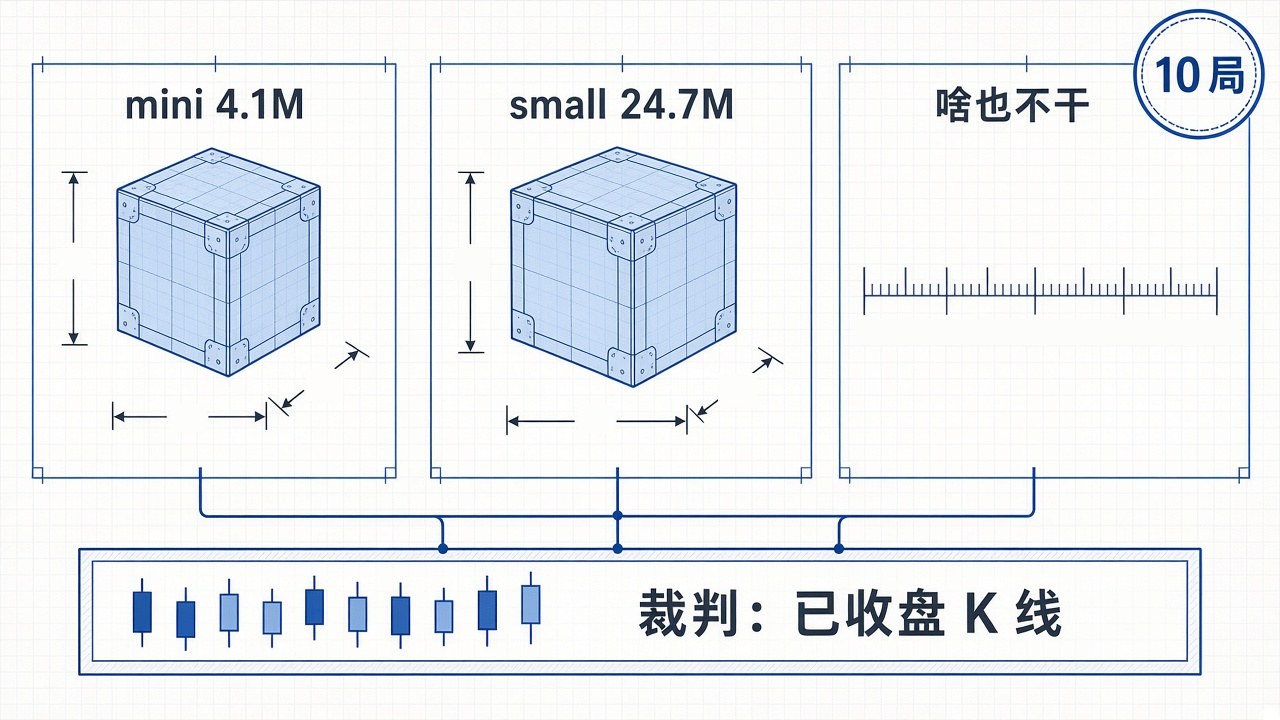
对手有三位。Kronos-mini(4.1M 参数),Kronos-small(24.7M 参数),还有一个什么都不会的笨办法:「明天每个小时的价格都等于现在」。这个笨办法我叫它「啥也不干」。
裁判是 OKX 公共行情里已经收盘的 K 线。一共 10 局,10 月 23 日到 11 月 1 日,窗口不重叠。筹码为零,我没开仓,也没打算开。
本次环境:作者的 Linux 测试机 · Linux x86_64 · 8 vCPU · 无 GPU · Python 3.13.5 · Kronos 仓库 HEAD 67b630e(2026-04-13)· 抓取与运行时间 2026-11-02 下午(UTC+8)。
它凭什么挤上今天的热榜
shiyu-coder/Kronos 今天在 GitHub Trending 日榜上 +630★,我 15 点前后用 gh api 查,累计 45,594★、7,523 个 fork,MIT 协议。项目其实不新,2025 年 7 月就建仓了,最近一批提交停在 2026 年 4 月 13 日,修的是采样里 top_k 的 bug 和归一化窗口的数据泄漏。
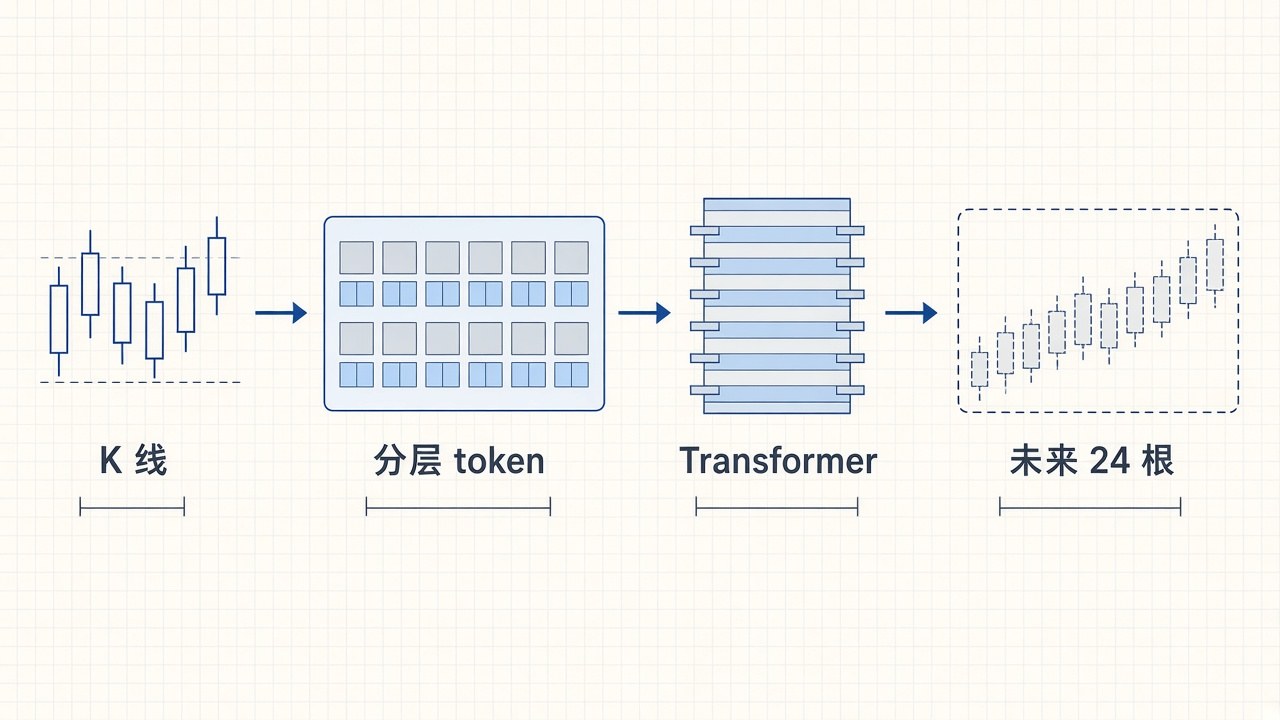
它的卖点写在 README 第一句:第一个开源的金融 K 线基础模型,训练数据来自 45 个以上的交易所。做法是把每根 K 线的开高低收和成交量先用一个专门的 tokenizer 切成分层的离散 token,再交给一个只有解码器的 Transformer 去「续写」。说白了,它把 K 线当成一门语言来学。论文在 arXiv 2508.02739,README 说已经被 AAAI 2026 接收。
开源的有三个尺寸:mini 4.1M、small 24.7M、base 102.3M。最大的 large 499.2M 没放出来。
赛前准备,大概半分钟
我没用 conda,直接开 venv。PyTorch 走 CPU 版的源,不然会把一大坨 CUDA 依赖拖下来:
git clone --depth 1 https://github.com/shiyu-coder/Kronos.git
python3 -m venv venv && . venv/bin/activate
pip install torch --index-url https://download.pytorch.org/whl/cpu   # 本机 16.6 秒
pip install numpy pandas einops huggingface_hub matplotlib tqdm safetensors   # 9.7 秒
装上的是 torch 2.15.0+cpu、pandas 3.1.0、numpy 2.5.4、huggingface_hub 2.4.0。官方 requirements.txt 钉的是 pandas 2.2.2 和 huggingface_hub 0.33.1,我偷懒没钉,跑下来没报错,只有 Hugging Face 提醒一句没设 HF_TOKEN 下载会限速。这一点后面还会回来说。
权重第一次加载时自动从 Hugging Face 下。下完看了一眼缓存:mini 16M,small 95M,两个 tokenizer 各 16M,四样加起来不到 150M。
数据这块踩了一个小坑。OKX 的 K 线接口不用 API Key,但我用 Python urllib 裸请求,直接回了 403 Forbidden。换 curl 带上浏览器 UA 就通了,所以脚本里补一行请求头:
u = "https://www.okx.com/api/v5/market/history-candles?instId=BTC-USDT&bar=1H&limit=100"
req = urllib.request.Request(u, headers={"User-Agent": "Mozilla/5.0"})
limit=100 一次只给 100 根,用 after 参数往前翻 10 页,去掉还没收盘的那根,落盘 999 根,从 9 月 21 日 23:00 到 11 月 2 日 13:00。
开赛
核心就一个调用。参数照 README 的默认,只把采样次数从 1 改成 5,让它自己先平均一下:
pred = predictor.predict(
    df=x[["open","high","low","close","volume","amount"]],
    x_timestamp=x_ts, y_timestamp=y_ts,
    pred_len=24,      # 往后猜 24 根,也就是一天
    T=1.0,            # 温度,越高越敢乱猜
    top_p=0.9,
    sample_count=5,   # 猜 5 条路径取平均
)
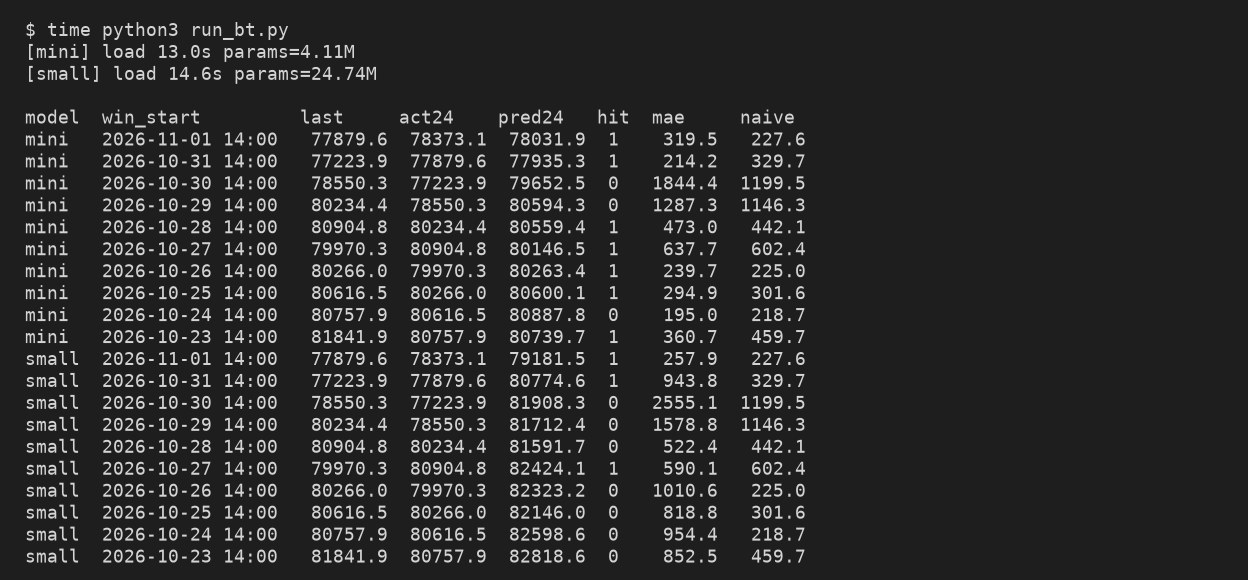
mini 和 small 各跑 10 局,种子固定 42。整套跑完 1 分 03 秒(含加载权重),CPU 的 user 时间是 4 分 19 秒,折算下来大概同时压了 4 个核。mini 单局平均 0.77 秒,small 2.68 秒。没 GPU 也完全等得起。
记分牌
「对」的意思是:第 24 根收盘相对出题时是涨是跌,模型说中了。价格单位 USDT。
| 出题日 14:00 | 出题时价格 | 24 小时后实际 | mini 说 | small 说 |
|---|---|---|---|---|
| 10-23 | 81,841.9 | 80,757.9 跌 | 80,739.7 对 | 82,818.6 错 |
| 10-24 | 80,757.9 | 80,616.5 跌 | 80,887.8 错 | 82,598.6 错 |
| 10-25 | 80,616.5 | 80,266.0 跌 | 80,600.1 对 | 82,146.0 错 |
| 10-26 | 80,266.0 | 79,970.3 跌 | 80,263.4 对 | 82,323.2 错 |
| 10-27 | 79,970.3 | 80,904.8 涨 | 80,146.5 对 | 82,424.1 对 |
| 10-28 | 80,904.8 | 80,234.4 跌 | 80,559.4 对 | 81,591.7 错 |
| 10-29 | 80,234.4 | 78,550.3 跌 | 80,594.3 错 | 81,712.4 错 |
| 10-30 | 78,550.3 | 77,223.9 跌 | 79,652.5 错 | 81,908.3 错 |
| 10-31 | 77,223.9 | 77,879.6 涨 | 77,935.3 对 | 80,774.6 对 |
| 11-01 | 77,879.6 | 78,373.1 涨 | 78,031.9 对 | 79,181.5 对 |
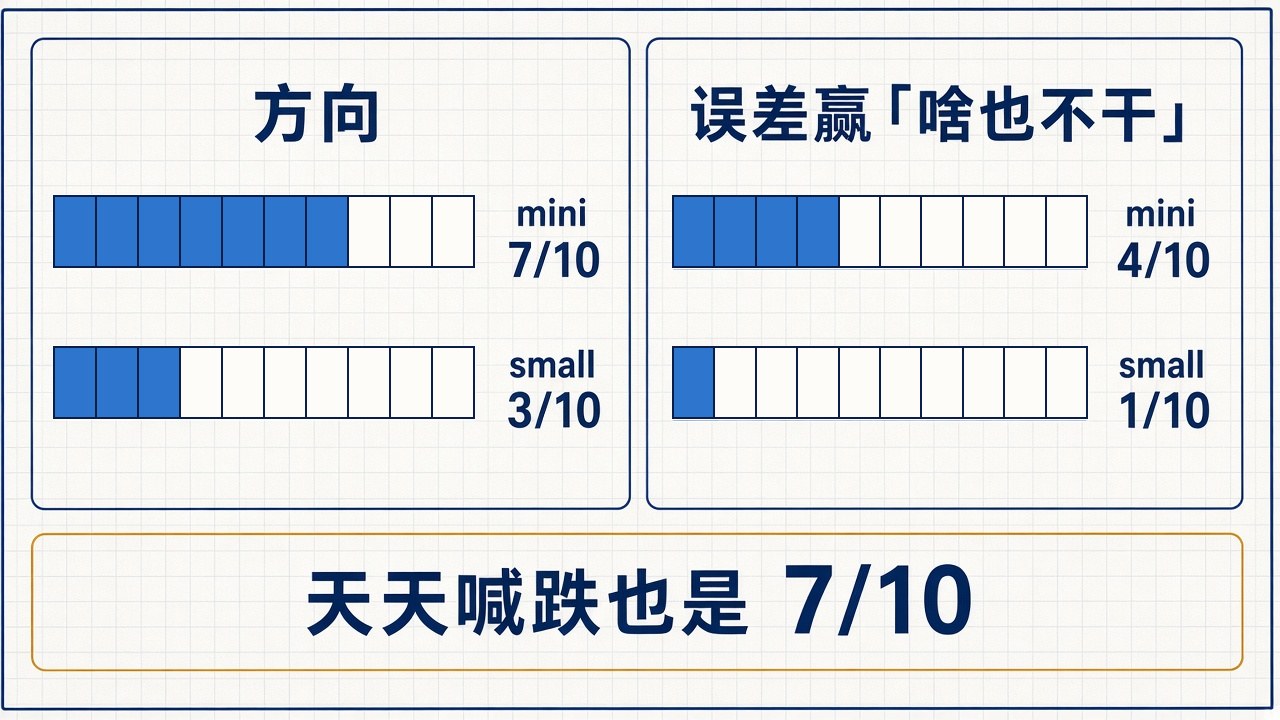
方向:mini 7/10,small 3/10。
误差:24 根平均绝对误差,mini 586.6,small 1,008.5,「啥也不干」515.3。逐局比,mini 只有 4 局比「啥也不干」准,small 只有 1 局。
看上去 mini 7 胜挺唬人。可这 10 天 BTC 是 3 涨 7 跌,一个闭着眼天天喊「跌」的人也是 7/10。还有 10-26 那局,mini 说 80,263.4,只比出题价低 2.6 美元,按规则也算它猜对了跌。我照记,但心里给它打了个问号。
翻车现场
最惨的是 10 月 30 日那局。出题前十来个小时,BTC 从 10-30 零点那根的最高 81,970.4 一路砸到上午 10 点那根的最低 76,519,到出题时又弹回 78,550。两个模型都觉得要继续反弹,small 尤其坚定,一口气画到 81,908。实际第二天下午收在 77,224,它差了 4,684 美元。
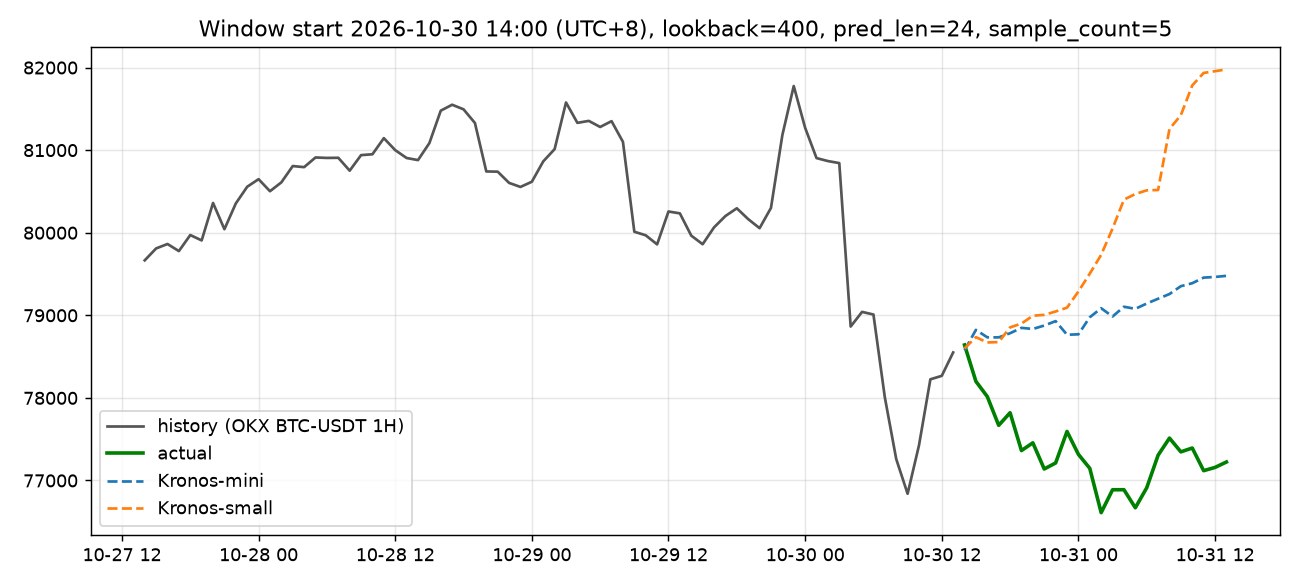
更让我好奇的是 small 那一列。10 局全部喊涨,一次都没喊过跌。
我第一反应是种子太巧,就换了 7 和 2026 两个种子把 10 局重跑一遍。结果还是 10/10 喊涨,三个种子加起来 30 次,30 次看多。mini 吃同一份数据会喊跌,至少说明不是我把数据喂反了。是 small 在这段行情上有偏,还是我没钉版本的新 pandas、新 numpy 在归一化那里动了什么,我现在说不准。手上没 GPU、也没时间再按官方版本搭一套环境复测,这个问题先挂在这里。
10 局太少,看看别人的
我这 10 局只能当个乐子。正好有人测得比我多,或者换了个口径测:
- 日本 Zenn 上有人 10 月 21 日用 Binance 公共数据测了 small,只测一个窗口,400 根猜 120 根,CPU 19.62 秒,逐小时方向命中 46.7%(CPU 那次)和 50.0%(GPU 那次),加大
sample_count到 10 反而降到 45.0%。原文 - GitHub 上的 kronos-market-eval 用 Kronos-base 在 BTC 上走了 100 个起点,24 小时方向 50/100,第 24 小时那个点的误差 skill 是 −118%,换算过来终点误差是「价格不动」的 2.18 倍,模型自己给的 p10 到 p90 区间只罩住了 21% 的真实价格。仓库
- 还有一份 Gist 把官方 Demo 自动提交的 4,682 条 24 小时预测翻出来对账,去掉重叠窗口后剩 196 条,方向命中 53.1%,95% 置信区间正负 7.0 个百分点。作者的说法比较客气,觉得有一点点信号,但 Demo 给的「上涨概率」偏自信。Gist
几份对下来,和我这 10 局的感觉对得上。它在 CPU 上跑得很轻快,可方向跟抛硬币没拉开距离,误差那一栏更难看,平均下来连一条水平直线都没赢。
我没测、也可能测错的地方
- 只有 10 局,只测了 BTC,只测了 1 小时线。
- 没测 base,没做微调。README 里有一整套 A 股微调加回测的流程,那是另一个话题。
- 依赖没按
requirements.txt钉版本。small 全喊涨这件事,在官方钉死的环境里会不会复现,我没验证。 - README 自己也写了,微调示例「not a production-ready quantitative trading system」,
finetune/目录里很多注释是 Gemini 2.5 Pro 生成的,可能不准。
我自己会拿它当时间序列玩具,或者塞进策略里当一个待验证的特征看看。单拿它一根曲线去开合约,我不敢。
留一道题
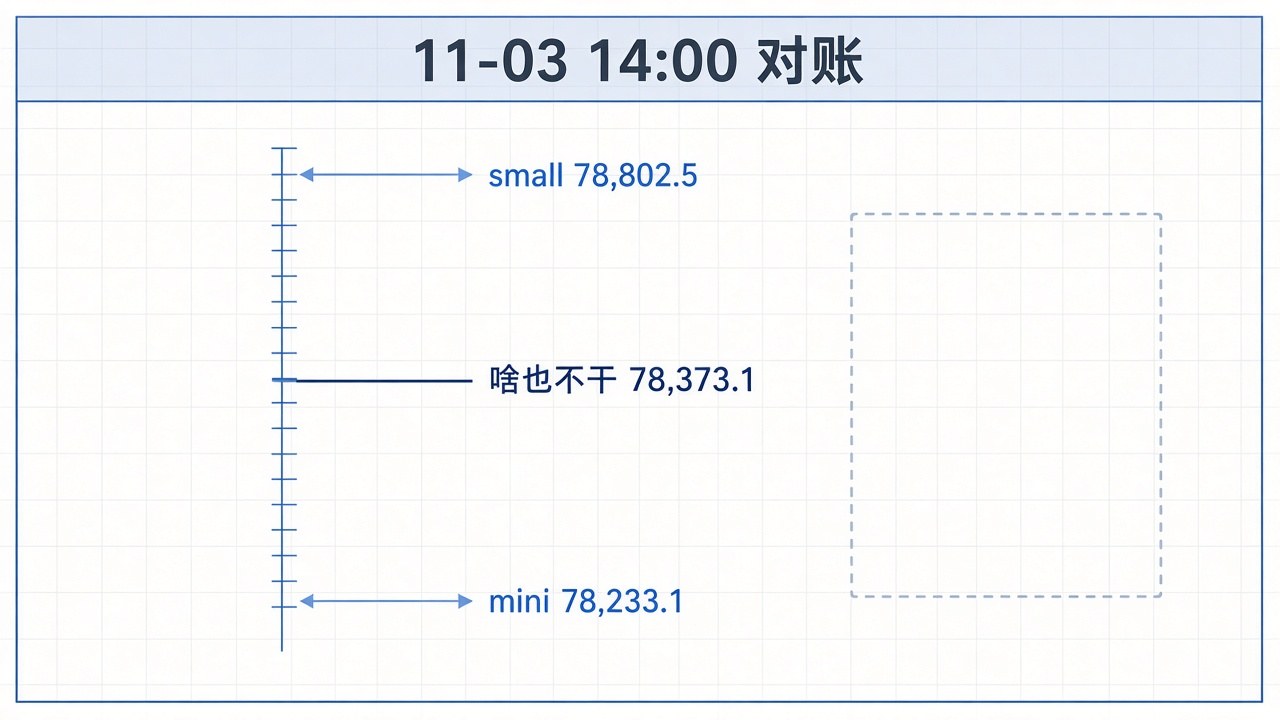
写到这儿是 11 月 2 日下午。我用最新一根已收盘的 K 线(OKX 开盘时间 11-02 13:00,收盘 78,373.1)又出了一题,问它们 24 小时后是多少:
- Kronos-mini:78,233.1
- Kronos-small:78,802.5
- 「啥也不干」:78,373.1
对账时间是 11 月 3 日 14:00(UTC+8),看 OKX BTC-USDT 1 小时线里开盘时间为 11-03 13:00 那根的收盘价。small 这次还是看涨。
两个脚本贴在文末附录,把 instId 改成 ETH-USDT 就能换币测。
出处
- 仓库:https://github.com/shiyu-coder/Kronos (MIT)
- 论文:https://arxiv.org/abs/2508.02739
- 官方 Demo:https://shiyu-coder.github.io/Kronos-demo/
- OKX 行情接口:
GET /api/v5/market/history-candles,https://www.okx.com/docs-v5/en/ (Market Data 一节,Get candlesticks history) - Zenn 实测:https://zenn.dev/matsushima_a/articles/day-022-kronos-btc-price-forecast?locale=en
- kronos-market-eval:https://github.com/sumit-ai-ml/kronos-market-eval
- 官方 Demo 预测对账 Gist:https://gist.github.com/moscowmule2240/1bb5bf350ad58e42199ac350f8768672
附录:本文用到的两个脚本
fetch_okx.py,拉 OKX 公共 1 小时 K 线,存成 CSV:
import json,urllib.request,time,pandas as pd
rows=[];after=''
for i in range(10):
    u=f"https://www.okx.com/api/v5/market/history-candles?instId=BTC-USDT&bar=1H&limit=100"+(f"&after={after}" if after else "")
    d=json.load(urllib.request.urlopen(urllib.request.Request(u,headers={"User-Agent":"Mozilla/5.0"}),timeout=20))['data']
    if not d: break
    rows+=d; after=d[-1][0]; time.sleep(0.3)
df=pd.DataFrame(rows,columns=['ts','open','high','low','close','volume','volCcy','amount','confirm'])
df=df[df.confirm=='1']
df['timestamps']=pd.to_datetime(df.ts.astype('int64'),unit='ms',utc=True).dt.tz_convert('Asia/Shanghai').dt.tz_localize(None)
for c in ['open','high','low','close','volume','amount']: df[c]=df[c].astype(float)
df=df.sort_values('timestamps').drop_duplicates('timestamps')[['timestamps','open','high','low','close','volume','amount']]
df.to_csv('btc_usdt_1h_okx.csv',index=False)
print(len(df),df.timestamps.min(),df.timestamps.max()); print(df.tail(3))
run_bt.py,放在 Kronos 仓库的上一级目录运行,10 局回测:
import sys,time,torch,numpy as np,pandas as pd
sys.path.insert(0,'Kronos')
from model import Kronos,KronosTokenizer,KronosPredictor
torch.manual_seed(42);np.random.seed(42)
df=pd.read_csv('btc_usdt_1h_okx.csv',parse_dates=['timestamps'])
cols=['open','high','low','close','volume','amount']
LB,PL,NW=400,24,10
specs={'mini':('NeoQuasar/Kronos-Tokenizer-2k','NeoQuasar/Kronos-mini',2048),
       'small':('NeoQuasar/Kronos-Tokenizer-base','NeoQuasar/Kronos-small',512)}
res=[]
for name,(tk,md,ctx) in specs.items():
    t0=time.time()
    tok=KronosTokenizer.from_pretrained(tk); m=Kronos.from_pretrained(md)
    print(f'[{name}] load {time.time()-t0:.1f}s params={sum(p.numel() for p in m.parameters())/1e6:.2f}M',flush=True)
    p=KronosPredictor(m,tok,device='cpu',max_context=ctx)
    for k in range(NW):
        end=len(df)-PL-k*PL   # first pred index
        x=df.iloc[end-LB:end]; y=df.iloc[end:end+PL]
        t1=time.time()
        pr=p.predict(df=x[cols].reset_index(drop=True),x_timestamp=x.timestamps.reset_index(drop=True),y_timestamp=y.timestamps.reset_index(drop=True),pred_len=PL,T=1.0,top_p=0.9,sample_count=5,verbose=False)
        dt=time.time()-t1
        last=x.close.iloc[-1]; act=y.close.values; pc=pr.close.values
        res.append(dict(model=name,win_start=str(y.timestamps.iloc[0]),last=last,act24=act[-1],pred24=pc[-1],
            dir_hit=int(np.sign(pc[-1]-last)==np.sign(act[-1]-last)),
            mae=float(np.mean(np.abs(pc-act))),naive_mae=float(np.mean(np.abs(last-act))),sec=round(dt,2)))
        print(res[-1],flush=True)
r=pd.DataFrame(res); r.to_csv('bt_results.csv',index=False)
print(r.groupby('model').agg(hit=('dir_hit','mean'),mae=('mae','mean'),naive=('naive_mae','mean'),sec=('sec','mean')))






